一张显卡,正在改变 AI 视频的生产方式
2026-09-06
08:53:10
来源: 李寿鹏
点击
在日前于广州举办、题为“智算于芯,创想无垠”的AIGC创作研讨会,英特尔中国区技术部总经理高宇表示,AI 视频正在经历比大语言模型更快的演进。从今年以来,新模型几乎每周都在出现,智能体和 AI 视频已经成为创作者最活跃的两条赛道。
他认为,AIGC 最大的意义是带来了“创意平权”。过去,一个导演梦需要昂贵的拍摄设备、制作团队和资金支持;而今天,只要拥有创意,以及一张具备足够算力的显卡,每个人都有机会完成自己的作品,让创意不再受限于制作门槛。
在高宇看来,本地创作会是一个不错的选择。而随着开源模型MiniMax H3的到来,就更成为首选。
MiniMax H3,带来变量
和过往我们熟悉的文字对话、文生图一样,视频生成领域,一直以来也都有开源和闭源之争。
过去很长一段时间,真正具备高质量视频生成能力的几乎都是闭源模型。创作者虽然能够获得更好的画质和效果,但代价是需要依赖云端平台,按 Token 计费、排队生成,工作流和模型能力也很难自由定制。本地部署更多停留在技术爱好者的尝试阶段,开源模型虽然存在,却难以满足商业级创作需求。
但随着MiniMax H3的到来,视频开源生态迎来了一个分水岭。 它并非追求参数最大,而是率先将多模态理解、镜头语言和角色关系等能力做到可用于生产,让开源视频模型第一次具备了商业落地的可能。这也意味着,视频生成开始从“只能在云端创作”,迈向“可以在本地生产”。
“MiniMax H3 的开源是一个重要变量。”高宇表示。他指出,过去不少开源视频模型更偏向体验和试玩,而 H3 是行业首次普遍认可、能够真正用于视频生产的开源模型。这意味着,端侧算力开始具备商业化价值,也让本地生成视频成为现实。
特别是在国内,因为AI短剧的快速崛起,市场对角色一致性、音画质量及镜头的动态连贯性提出了影音级别的高要求。然而,昂贵的算力与复杂的部署更让大量中小型团队和个人创作者望而却步。与此同时,技术能力向少数闭源模型的过度集中,也让创意表达难以充分施展。
更重要的是,如高宇所说,当前 AI 视频产业真正的瓶颈并不是模型,而是算力成本。如今主流视频生成平台普遍存在排队、抽卡、等待等问题,一部高质量 AI 视频背后的算力开销仍然很高。更重要的是,与大语言模型可以通过专家并行、PD 分离等方式不断提升并发不同,视频生成本身属于算力密集型任务,并发能力提升有限,因此云端成本短期内难以根本改善。为此,打造本地算力生态,正在成为不少厂商考虑的方向。
不过,正如英特尔技术专家所说,本地生成并不是新需求,只是过去受限于模型能力而被压抑。而MiniMax H3 等开源模型的出现,让本地创作真正具备可行性,起主要价值体现在四个方面:
数据隐私:创意、设计和商业内容无需上传云端,核心资产更安全。
高度定制:可自由搭建 ComfyUI 工作流、训练 LoRA、接入第三方工具,形成个人创作壁垒。
创作自由:无需排队、审核或消耗 Token,可以无限次迭代作品。
成本优势:长期来看,本地算力比持续购买云端算力更具经济性,尤其适合视频创作者和创业团队。
面对这样的需求,一个可靠的本地算力是重中之重,而锐炫 Pro B70 ,正在成为其中一个重要选择。
凭啥是锐炫 Pro B70?
“本地算力未来不会完全取代云端,而是形成‘本地为主、按需上云’的混合生态。”英特尔专家强调。他进一步指出,AIGC 本质上应该是一个开放市场,创作者需要除了云厂商之外,更具性价比、更开放的本地 GPU 方案,而这正是英特尔锐炫 Pro 系列切入的机会。
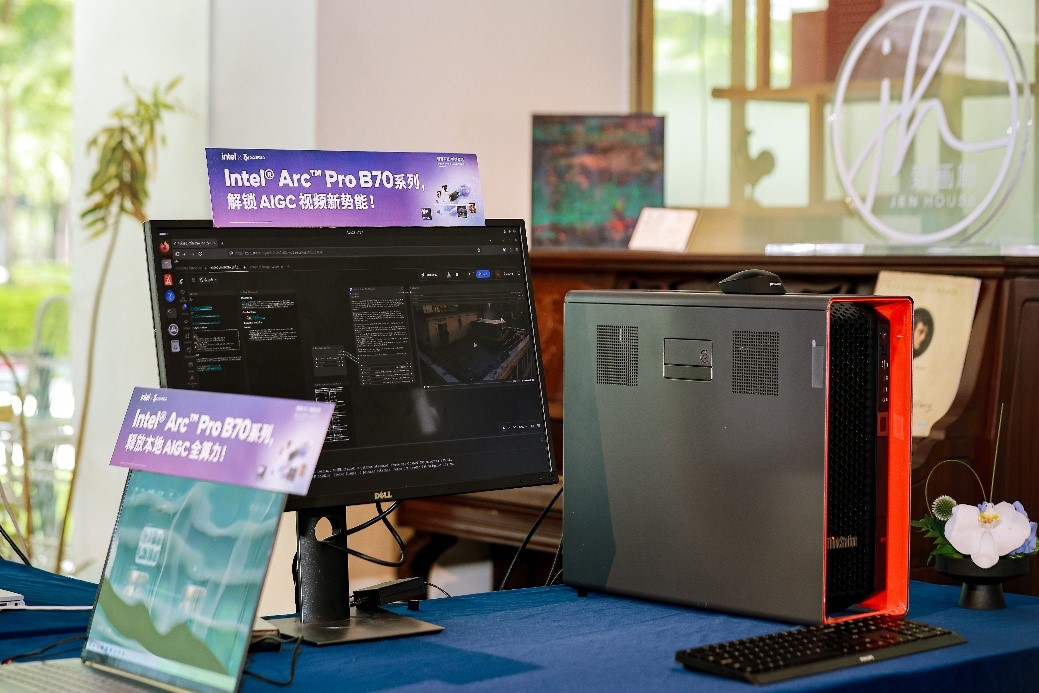
作为生产力级别智能体推理卡,英特尔锐炫Pro B70专业级显卡为专业设计与AI创作而生,集32GB大显存、367 TOPS算力、硬件级编解码能力与AI加速引擎于一体。依托强大的本地算力与显存优势,锐炫Pro B70能进一步提升模型加载与采样效率,稳定运行从剧本创意、素材生成、视频剪辑、配音配乐到成片交付的AIGC全流程创作。在AI漫剧等新兴场景中,锐炫Pro B70贯穿本地生成、超分、资产整理与剪辑全流程,全面支持智能体驱动的AI创作新范式:
VLM多媒体资产智能整理:利用英特尔多模态能力与锐炫Pro B70的本地算力,完成从“视频硬件解码—智能分段—采样/片段—高并发VLM加速—总结报告”的完整链路,支持对多媒体素材进行自动标定与归类,并提供本地语义检索功能,显著提升剧本与素材整理效率。
专业级剪辑性能:搭载双路硬件编解码单元,支持8K@120Hz、HDR等格式,可流畅剪辑10轨以上4K视频;此外还针对剪映、DaVinci Resolve、Adobe Premiere Pro及Photoshop等专业后期软件进行了适配与优化,带来极为流畅的专业创作体验。
高效AI生图与生视频:锐炫Pro B70第一时间完成对开源模型MiniMax H3的Day 0适配,并持续进行软件优化。基于32GB大显存与性价比优势,英特尔在提供开箱即用的本地AI创作体验的同时,深化与ISV合作伙伴的协同,为内容创作者打造低门槛、低成本的高效视频生产路径。
大模型与视频智能体支持:依托32GB显存,锐炫Pro B70可运行Qwen3.8-27B Q4_KM大语言模型,打开MTP,解码速率可达52 TPS,并支持256K上下文窗口。该本地推理能力为视频智能体搭建了坚实的算力底座,在满足数据隐私与离线使用的需求下,帮助企业与创作者有效控制运营成本。
正是在这样一颗算力卡的支持下,英特尔正在协助开发者使用混合模式更好地支持客户。
“英特尔希望打造的不是一张显卡,而是一套完整生态:联合 MiniMax、数字折叠、OEM 工作站和显卡厂商,提供开箱即用的本地 AIGC 创作方案,让创作者拥有更自由、更高效、成本可控的生产环境。”该位英特尔技术团队成员强调。
他进一步指出,2026 年最大的趋势不是单纯生成视频,而是视频智能体(Video Agent)。
他的判断是:主流端侧智能体将收敛到 30B 左右 Dense 模型;单张 32GB 显存 GPU 已能部署具备生产力的智能体;真正重要的不是模型大小,而是 Token 吞吐速度,只有达到约 50 Token/s,智能体才能胜任连续工作流。
因此,本地智能体将承担从视频理解、高光提取、脚本整理,到片头片尾生成的完整流程,把创作者从具体操作中解放出来。
写在最后
如果说过去一年,AI 视频竞争的焦点是谁的模型更强,那么这场研讨会释放出的另一个信号则是:竞争正在从模型走向生产力。
真正值得关注的,不是某一款硬件或模型的出现,而是一个新的创作生态正在形成。当开源模型负责降低算法门槛,本地算力承担稳定可控的计算能力,Agent 与工作流进一步简化创作流程,AI 视频的生产方式也开始发生变化——创作者关注的不再是如何部署环境、购买 Token,而是如何把一个想法快速变成一支作品。
对于整个 AIGC 行业而言,这或许意味着 AI 视频正从“技术展示”走向“内容生产”。当创作门槛持续下降、生产效率不断提升,真正被释放的,将是更广泛的创意与内容供给。
他认为,AIGC 最大的意义是带来了“创意平权”。过去,一个导演梦需要昂贵的拍摄设备、制作团队和资金支持;而今天,只要拥有创意,以及一张具备足够算力的显卡,每个人都有机会完成自己的作品,让创意不再受限于制作门槛。
在高宇看来,本地创作会是一个不错的选择。而随着开源模型MiniMax H3的到来,就更成为首选。
MiniMax H3,带来变量
和过往我们熟悉的文字对话、文生图一样,视频生成领域,一直以来也都有开源和闭源之争。
过去很长一段时间,真正具备高质量视频生成能力的几乎都是闭源模型。创作者虽然能够获得更好的画质和效果,但代价是需要依赖云端平台,按 Token 计费、排队生成,工作流和模型能力也很难自由定制。本地部署更多停留在技术爱好者的尝试阶段,开源模型虽然存在,却难以满足商业级创作需求。
但随着MiniMax H3的到来,视频开源生态迎来了一个分水岭。 它并非追求参数最大,而是率先将多模态理解、镜头语言和角色关系等能力做到可用于生产,让开源视频模型第一次具备了商业落地的可能。这也意味着,视频生成开始从“只能在云端创作”,迈向“可以在本地生产”。
“MiniMax H3 的开源是一个重要变量。”高宇表示。他指出,过去不少开源视频模型更偏向体验和试玩,而 H3 是行业首次普遍认可、能够真正用于视频生产的开源模型。这意味着,端侧算力开始具备商业化价值,也让本地生成视频成为现实。
特别是在国内,因为AI短剧的快速崛起,市场对角色一致性、音画质量及镜头的动态连贯性提出了影音级别的高要求。然而,昂贵的算力与复杂的部署更让大量中小型团队和个人创作者望而却步。与此同时,技术能力向少数闭源模型的过度集中,也让创意表达难以充分施展。
更重要的是,如高宇所说,当前 AI 视频产业真正的瓶颈并不是模型,而是算力成本。如今主流视频生成平台普遍存在排队、抽卡、等待等问题,一部高质量 AI 视频背后的算力开销仍然很高。更重要的是,与大语言模型可以通过专家并行、PD 分离等方式不断提升并发不同,视频生成本身属于算力密集型任务,并发能力提升有限,因此云端成本短期内难以根本改善。为此,打造本地算力生态,正在成为不少厂商考虑的方向。
不过,正如英特尔技术专家所说,本地生成并不是新需求,只是过去受限于模型能力而被压抑。而MiniMax H3 等开源模型的出现,让本地创作真正具备可行性,起主要价值体现在四个方面:
数据隐私:创意、设计和商业内容无需上传云端,核心资产更安全。
高度定制:可自由搭建 ComfyUI 工作流、训练 LoRA、接入第三方工具,形成个人创作壁垒。
创作自由:无需排队、审核或消耗 Token,可以无限次迭代作品。
成本优势:长期来看,本地算力比持续购买云端算力更具经济性,尤其适合视频创作者和创业团队。
面对这样的需求,一个可靠的本地算力是重中之重,而锐炫 Pro B70 ,正在成为其中一个重要选择。
凭啥是锐炫 Pro B70?
“本地算力未来不会完全取代云端,而是形成‘本地为主、按需上云’的混合生态。”英特尔专家强调。他进一步指出,AIGC 本质上应该是一个开放市场,创作者需要除了云厂商之外,更具性价比、更开放的本地 GPU 方案,而这正是英特尔锐炫 Pro 系列切入的机会。
作为生产力级别智能体推理卡,英特尔锐炫Pro B70专业级显卡为专业设计与AI创作而生,集32GB大显存、367 TOPS算力、硬件级编解码能力与AI加速引擎于一体。依托强大的本地算力与显存优势,锐炫Pro B70能进一步提升模型加载与采样效率,稳定运行从剧本创意、素材生成、视频剪辑、配音配乐到成片交付的AIGC全流程创作。在AI漫剧等新兴场景中,锐炫Pro B70贯穿本地生成、超分、资产整理与剪辑全流程,全面支持智能体驱动的AI创作新范式:
VLM多媒体资产智能整理:利用英特尔多模态能力与锐炫Pro B70的本地算力,完成从“视频硬件解码—智能分段—采样/片段—高并发VLM加速—总结报告”的完整链路,支持对多媒体素材进行自动标定与归类,并提供本地语义检索功能,显著提升剧本与素材整理效率。
专业级剪辑性能:搭载双路硬件编解码单元,支持8K@120Hz、HDR等格式,可流畅剪辑10轨以上4K视频;此外还针对剪映、DaVinci Resolve、Adobe Premiere Pro及Photoshop等专业后期软件进行了适配与优化,带来极为流畅的专业创作体验。
高效AI生图与生视频:锐炫Pro B70第一时间完成对开源模型MiniMax H3的Day 0适配,并持续进行软件优化。基于32GB大显存与性价比优势,英特尔在提供开箱即用的本地AI创作体验的同时,深化与ISV合作伙伴的协同,为内容创作者打造低门槛、低成本的高效视频生产路径。
大模型与视频智能体支持:依托32GB显存,锐炫Pro B70可运行Qwen3.8-27B Q4_KM大语言模型,打开MTP,解码速率可达52 TPS,并支持256K上下文窗口。该本地推理能力为视频智能体搭建了坚实的算力底座,在满足数据隐私与离线使用的需求下,帮助企业与创作者有效控制运营成本。
正是在这样一颗算力卡的支持下,英特尔正在协助开发者使用混合模式更好地支持客户。
“英特尔希望打造的不是一张显卡,而是一套完整生态:联合 MiniMax、数字折叠、OEM 工作站和显卡厂商,提供开箱即用的本地 AIGC 创作方案,让创作者拥有更自由、更高效、成本可控的生产环境。”该位英特尔技术团队成员强调。
他进一步指出,2026 年最大的趋势不是单纯生成视频,而是视频智能体(Video Agent)。
他的判断是:主流端侧智能体将收敛到 30B 左右 Dense 模型;单张 32GB 显存 GPU 已能部署具备生产力的智能体;真正重要的不是模型大小,而是 Token 吞吐速度,只有达到约 50 Token/s,智能体才能胜任连续工作流。
因此,本地智能体将承担从视频理解、高光提取、脚本整理,到片头片尾生成的完整流程,把创作者从具体操作中解放出来。
写在最后
如果说过去一年,AI 视频竞争的焦点是谁的模型更强,那么这场研讨会释放出的另一个信号则是:竞争正在从模型走向生产力。
真正值得关注的,不是某一款硬件或模型的出现,而是一个新的创作生态正在形成。当开源模型负责降低算法门槛,本地算力承担稳定可控的计算能力,Agent 与工作流进一步简化创作流程,AI 视频的生产方式也开始发生变化——创作者关注的不再是如何部署环境、购买 Token,而是如何把一个想法快速变成一支作品。
对于整个 AIGC 行业而言,这或许意味着 AI 视频正从“技术展示”走向“内容生产”。当创作门槛持续下降、生产效率不断提升,真正被释放的,将是更广泛的创意与内容供给。
责任编辑:SemiInsights
相关文章
-
- 半导体行业观察
-
- 摩尔芯闻
最新新闻
热门文章 本日 七天 本月
热门评论
©2025 半导体行业观察
Copyright©2023 芯算智能科技(扬州)有限公司
苏ICP备2025200240号-2 皖公网安备 34019202000656号