从算力竞争到词元经济:AI推动数据分层,闪存走到岔路口
2026-10-09
12:15:45
来源: 互联网
点击
如果说过去的大模型时代,比拼的是谁拥有更多GPU,那么AI Agent时代,比拼的将是谁拥有更高效的数据系统。
原因很简单。AI Agent不再只是回答一个问题,而是具备规划、调用工具、访问知识库、长期记忆和持续执行任务的能力。一次复杂任务背后,往往伴随着数十甚至数百次数据读取、检索与写入,真正成为AI系统中最活跃的,已经不只是算力,而是数据。与此同时,AI 数据中心正在从“算力经济”走向“Token 经济”。随着每一次推理、每一个 AI Agent 都要消耗大量 Token,数据访问成本开始直接影响单Token的生成成本。
在这些因素推动下,数据中心从统一存储架构演进为计算层与容量层并存的存储分层架构。
AI正在推动数据分层
同样都是数据,却不再需要同样的存储,这是AI工作负载给存储带来的最大变化。除了性能需求以外,归根到底,这主要是因为数据中心中真正昂贵的是GPU时间,而不是SSD本身。因此把不同价值的数据放到不同存储层,就是降低Token成本最有效的方式之一。
具体而言,在训练阶段,需要持续不断地向GPU提供海量数据,强调的是高吞吐和并行访问;推理阶段,则更加依赖碎片化的小数据读取,以及对上下文信息的快速响应;而AI Agent 又进一步引入了长期记忆、RAG知识库和KV Cache,使热点数据与海量历史数据同时存在于系统中。
这意味着,架构师思考的问题已经不再是“部署多少存储”,而变成了哪些数据应该距离GPU最近,哪些数据应该放在容量层,如何让不同层级协同工作。在此期间,存储的位置,也随之发生改变。延迟最敏感的数据,会部署在GPU与AI加速器附近;容量型数据则被解耦至独立的数据湖,通过高速网络持续向计算集群供数。
于是,在一座AI数据中心,开始形成两条截然不同的数据通路。
第一层:靠近GPU的计算优化型存储;
距离GPU最近的这一层,业内通常称为计算优化型eSSD。它承担的并不是传统意义上的“保存文件”,而是AI最核心的数据交换任务:模型加载、Checkpoint保存、高速数据流转,以及如今增长最快的KV Cache(键值缓存)。尤其在AI Agent普及之后,KV Cache正成为新的存储热点。每一次Agent与用户持续对话,或调用多个工具执行复杂任务,都需要保留大量上下文信息。过去,这些缓存主要依赖昂贵的DRAM;但随着上下文窗口不断扩大,封装内存容量已经越来越难以支撑,于是大量KV Cache 开始卸载至企业级SSD。
因此,计算优化型SSD的定位正在发生变化——它不只是存储设备,更像是DRAM与传统存储之间的新一级内存层。它既提供远超内存的容量,又保持接近计算侧所需的低延迟与高 IOPS,成为GPU持续高利用率的重要保障。
第二层:容量优化型存储,支撑AI数据湖;
这条数据通路属于容量优化型eSSD。AI并没有创造新的数据类型,却彻底改变了数据的访问方式。过去的数据湖更多服务于分析查询,而今天的大模型训练,需要高速读取整个数据集,数据湖开始从“存得下”走向“读得快”。因此,新一代AI数据湖更加关注三个指标:容量密度、能效,以及持续吞吐。
对于PB级数据而言,决定总体拥有成本(TCO)的,往往不是峰值性能,而是单位瓦特能够存储和传输多少数据。容量优化型SSD正是围绕这一目标设计,它以更高密度的NAND闪存替代大量机械硬盘,在降低功耗与机架空间占用的同时,为GPU集群持续提供稳定的数据供给。
更重要的是,许多原本属于“冷数据”的数据集,在AI训练过程中会被频繁访问,逐渐变成“温数据”。这也推动越来越多的数据中心,从HDD+SSD的传统分层,转向全闪存数据湖架构。
而支撑这一切的底层技术,是QLC NAND。
QLC担当大任
SSD的类型很多,但QLC(Quad-Level Cell)通过在每个存储单元存储4 bit数据(对应16个电压状态),大幅提升了NAND闪存的存储密度,这让其成为了数据中心存储的首选。虽然其随机性能不及部分高性能NAND,但在规模化部署场景下,QLC能够提供更低的每比特成本和更高的能效,这正契合AI数据湖对海量数据存储的需求。
对于数据中心而言,QLC另一个价值在于容量优化。它能够以高密度闪存替代多块机械硬盘,在相同机架空间内提供更大的存储容量,同时降低功耗、散热和物理占用,从而显著改善整体拥有成本(TCO)。
更重要的是,QLC 让存储分层真正成为现实。架构师无需再依赖一种SSD兼顾所有负载,而是可以将高性能NAND部署在靠近GPU的计算层,负责训练、推理和KV Cache等热点数据;将QLC NAND部署在容量层,支撑AI数据湖、海量训练数据和长期知识库等场景。通过不同层级各司其职,AI数据中心得以在性能、容量与成本之间实现更优平衡。
闪迪先进的eSSD产品组合
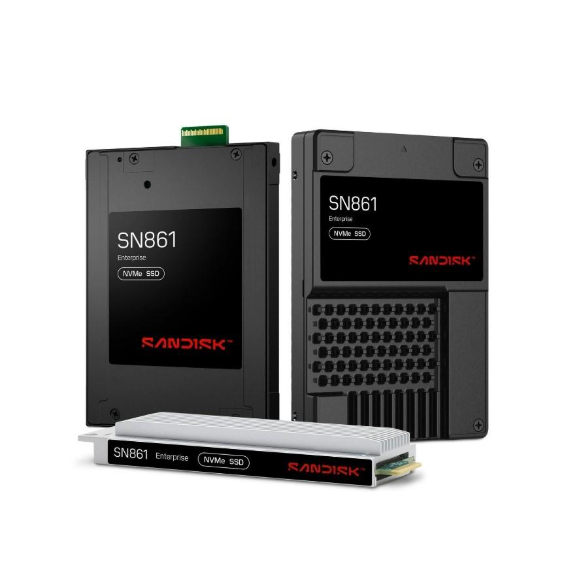
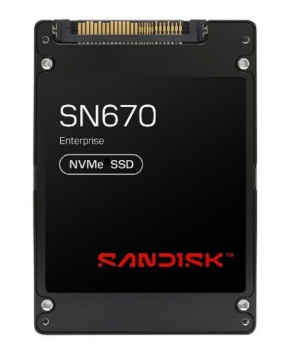
作为行业领先专家,闪迪公司旗下的两款旗舰级eSSD产品——SANDISK SN861 NVMe SSD和SANDISK SN670 NVMe SSD,展现了卓越的性能与容量优势。
据介绍,SANDISK SN861 NVMe SSD的定位是面向 AI 训练与推理的计算优化型企业级 SSD。产品采用 PCIe Gen5 接口,具备高随机读写性能、超低延迟和高达16TB容量,可满足大语言模型训练、推理及 AI 服务部署对高速数据访问的需求。
同时,闪迪SN861通过更高的 IOPS/Watt 提升能效,帮助数据中心降低整体拥有成本(TCO);全面兼容 NVMe 2.0和OCP 2.0规范,并支持FDP(Flexible Data Placement)技术,可有效降低写入放大、延长 SSD 寿命,并提升性能一致性和 QoS。此外,其E1.S 版本已通过 NVIDIA GB200 NVL72 认证,U.2与E1.S版本均获得OCP Inspired™认证,适用于新一代 AI 加速计算平台。
至于SANDISK SN670 NVMe SSD ,则是闪迪面向 AI 数据湖等存储密集型场景打造,基于闪迪UltraQLC™平台,整合BiCS8 QLC CBA NAND、定制化控制器与系统级调优,实现最高256TB 超大容量的产品。产品在容量、性能与能效之间实现平衡,可为高速 AI 数据湖、海量训练数据存储及AI数据准备提供高密度、可扩展的企业级存储底座。
写在最后
基于这些领先产品,闪迪为当下的人工智能提供了广泛的支持,但公司并没有放慢前进的步伐。例如在8月初于美国举办的FMS 2026上,闪迪展示了下一代NAND闪存技术——BiCS10 QLC NAND:面向AI、云和数据中心,旨在提升存储的密度、性能和能效。除此以外,闪迪还展示了HBF和企业级SSD等技术,以满足AI推理在容量、性能和能效方面的要求。
闪迪公司首席产品官Khurram Ismail在这次峰会上展望道,“AI基础设施已迈入新发展阶段,高效存储、传输和访问数据的能力,已变得与计算能力同样重要。随着推理工作负载的增长,客户亟需既不增加复杂性,又能兼具理想性能、容量和能效的内存与存储技术。依托数十年的闪存创新积淀,闪迪致力于推进下一代NAND闪存技术和HBF等新兴技术,助力行业发展。”
原因很简单。AI Agent不再只是回答一个问题,而是具备规划、调用工具、访问知识库、长期记忆和持续执行任务的能力。一次复杂任务背后,往往伴随着数十甚至数百次数据读取、检索与写入,真正成为AI系统中最活跃的,已经不只是算力,而是数据。与此同时,AI 数据中心正在从“算力经济”走向“Token 经济”。随着每一次推理、每一个 AI Agent 都要消耗大量 Token,数据访问成本开始直接影响单Token的生成成本。
在这些因素推动下,数据中心从统一存储架构演进为计算层与容量层并存的存储分层架构。
AI正在推动数据分层
同样都是数据,却不再需要同样的存储,这是AI工作负载给存储带来的最大变化。除了性能需求以外,归根到底,这主要是因为数据中心中真正昂贵的是GPU时间,而不是SSD本身。因此把不同价值的数据放到不同存储层,就是降低Token成本最有效的方式之一。
具体而言,在训练阶段,需要持续不断地向GPU提供海量数据,强调的是高吞吐和并行访问;推理阶段,则更加依赖碎片化的小数据读取,以及对上下文信息的快速响应;而AI Agent 又进一步引入了长期记忆、RAG知识库和KV Cache,使热点数据与海量历史数据同时存在于系统中。
这意味着,架构师思考的问题已经不再是“部署多少存储”,而变成了哪些数据应该距离GPU最近,哪些数据应该放在容量层,如何让不同层级协同工作。在此期间,存储的位置,也随之发生改变。延迟最敏感的数据,会部署在GPU与AI加速器附近;容量型数据则被解耦至独立的数据湖,通过高速网络持续向计算集群供数。
于是,在一座AI数据中心,开始形成两条截然不同的数据通路。
第一层:靠近GPU的计算优化型存储;
距离GPU最近的这一层,业内通常称为计算优化型eSSD。它承担的并不是传统意义上的“保存文件”,而是AI最核心的数据交换任务:模型加载、Checkpoint保存、高速数据流转,以及如今增长最快的KV Cache(键值缓存)。尤其在AI Agent普及之后,KV Cache正成为新的存储热点。每一次Agent与用户持续对话,或调用多个工具执行复杂任务,都需要保留大量上下文信息。过去,这些缓存主要依赖昂贵的DRAM;但随着上下文窗口不断扩大,封装内存容量已经越来越难以支撑,于是大量KV Cache 开始卸载至企业级SSD。
因此,计算优化型SSD的定位正在发生变化——它不只是存储设备,更像是DRAM与传统存储之间的新一级内存层。它既提供远超内存的容量,又保持接近计算侧所需的低延迟与高 IOPS,成为GPU持续高利用率的重要保障。
第二层:容量优化型存储,支撑AI数据湖;
这条数据通路属于容量优化型eSSD。AI并没有创造新的数据类型,却彻底改变了数据的访问方式。过去的数据湖更多服务于分析查询,而今天的大模型训练,需要高速读取整个数据集,数据湖开始从“存得下”走向“读得快”。因此,新一代AI数据湖更加关注三个指标:容量密度、能效,以及持续吞吐。
对于PB级数据而言,决定总体拥有成本(TCO)的,往往不是峰值性能,而是单位瓦特能够存储和传输多少数据。容量优化型SSD正是围绕这一目标设计,它以更高密度的NAND闪存替代大量机械硬盘,在降低功耗与机架空间占用的同时,为GPU集群持续提供稳定的数据供给。
更重要的是,许多原本属于“冷数据”的数据集,在AI训练过程中会被频繁访问,逐渐变成“温数据”。这也推动越来越多的数据中心,从HDD+SSD的传统分层,转向全闪存数据湖架构。
而支撑这一切的底层技术,是QLC NAND。
QLC担当大任
SSD的类型很多,但QLC(Quad-Level Cell)通过在每个存储单元存储4 bit数据(对应16个电压状态),大幅提升了NAND闪存的存储密度,这让其成为了数据中心存储的首选。虽然其随机性能不及部分高性能NAND,但在规模化部署场景下,QLC能够提供更低的每比特成本和更高的能效,这正契合AI数据湖对海量数据存储的需求。
对于数据中心而言,QLC另一个价值在于容量优化。它能够以高密度闪存替代多块机械硬盘,在相同机架空间内提供更大的存储容量,同时降低功耗、散热和物理占用,从而显著改善整体拥有成本(TCO)。
更重要的是,QLC 让存储分层真正成为现实。架构师无需再依赖一种SSD兼顾所有负载,而是可以将高性能NAND部署在靠近GPU的计算层,负责训练、推理和KV Cache等热点数据;将QLC NAND部署在容量层,支撑AI数据湖、海量训练数据和长期知识库等场景。通过不同层级各司其职,AI数据中心得以在性能、容量与成本之间实现更优平衡。
闪迪先进的eSSD产品组合
作为行业领先专家,闪迪公司旗下的两款旗舰级eSSD产品——SANDISK SN861 NVMe SSD和SANDISK SN670 NVMe SSD,展现了卓越的性能与容量优势。
据介绍,SANDISK SN861 NVMe SSD的定位是面向 AI 训练与推理的计算优化型企业级 SSD。产品采用 PCIe Gen5 接口,具备高随机读写性能、超低延迟和高达16TB容量,可满足大语言模型训练、推理及 AI 服务部署对高速数据访问的需求。
同时,闪迪SN861通过更高的 IOPS/Watt 提升能效,帮助数据中心降低整体拥有成本(TCO);全面兼容 NVMe 2.0和OCP 2.0规范,并支持FDP(Flexible Data Placement)技术,可有效降低写入放大、延长 SSD 寿命,并提升性能一致性和 QoS。此外,其E1.S 版本已通过 NVIDIA GB200 NVL72 认证,U.2与E1.S版本均获得OCP Inspired™认证,适用于新一代 AI 加速计算平台。
至于SANDISK SN670 NVMe SSD ,则是闪迪面向 AI 数据湖等存储密集型场景打造,基于闪迪UltraQLC™平台,整合BiCS8 QLC CBA NAND、定制化控制器与系统级调优,实现最高256TB 超大容量的产品。产品在容量、性能与能效之间实现平衡,可为高速 AI 数据湖、海量训练数据存储及AI数据准备提供高密度、可扩展的企业级存储底座。
写在最后
基于这些领先产品,闪迪为当下的人工智能提供了广泛的支持,但公司并没有放慢前进的步伐。例如在8月初于美国举办的FMS 2026上,闪迪展示了下一代NAND闪存技术——BiCS10 QLC NAND:面向AI、云和数据中心,旨在提升存储的密度、性能和能效。除此以外,闪迪还展示了HBF和企业级SSD等技术,以满足AI推理在容量、性能和能效方面的要求。
闪迪公司首席产品官Khurram Ismail在这次峰会上展望道,“AI基础设施已迈入新发展阶段,高效存储、传输和访问数据的能力,已变得与计算能力同样重要。随着推理工作负载的增长,客户亟需既不增加复杂性,又能兼具理想性能、容量和能效的内存与存储技术。依托数十年的闪存创新积淀,闪迪致力于推进下一代NAND闪存技术和HBF等新兴技术,助力行业发展。”
责任编辑:SemiInsights
相关文章
-
- 半导体行业观察
-
- 摩尔芯闻
最新新闻
热门文章 本日 七天 本月
热门评论
©2025 半导体行业观察
Copyright©2023 芯算智能科技(扬州)有限公司
苏ICP备2025200240号-2 皖公网安备 34019202000656号