英特尔CPU,Agent时代的主角
2026-11-12
12:12:15
来源: 互联网
点击
因为人工智能火热,Token已经成为了一个全球热词。
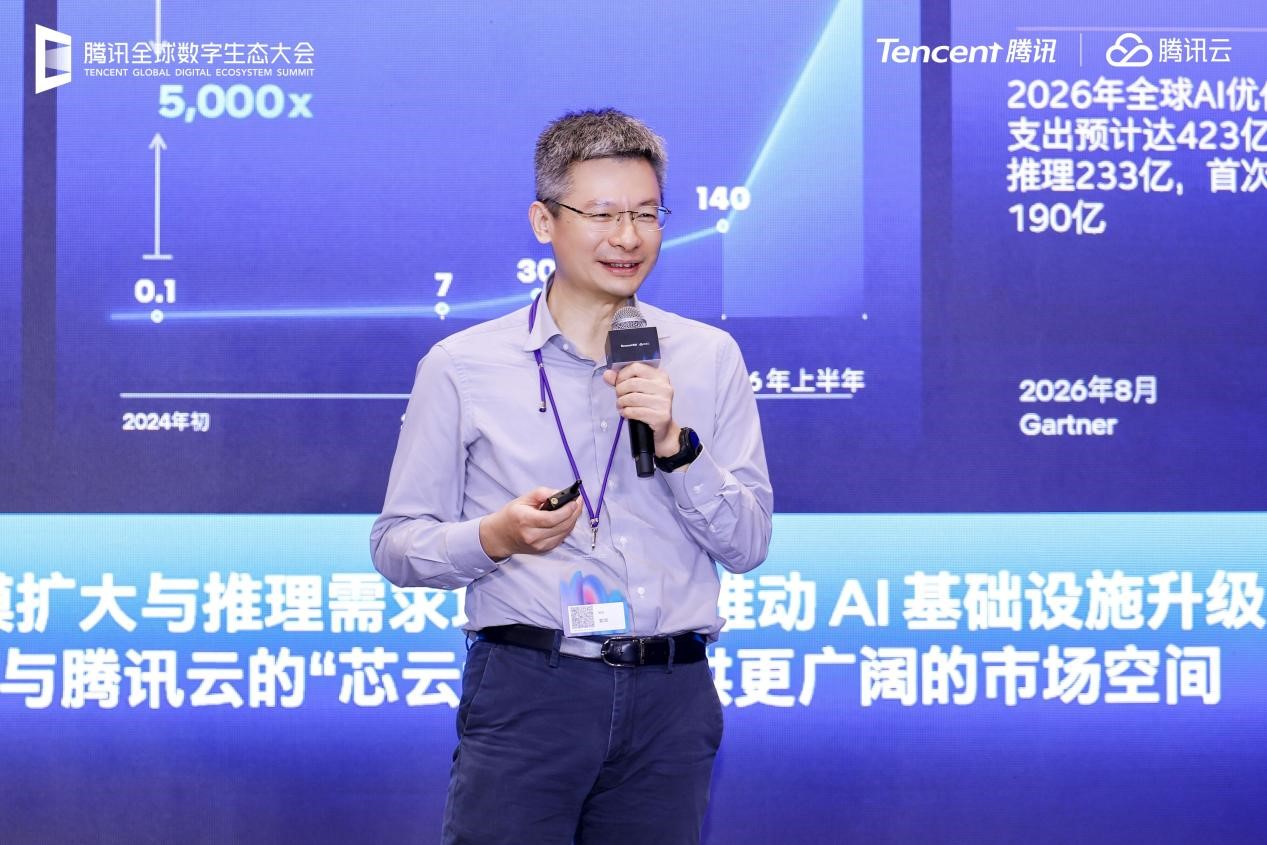
英特尔市场营销集团副总裁、中国区总经理郭威在日前举办的“腾讯全球数字生态大会英特尔专场”演讲中也指出,中国大模型日均调用量在两年内增长了5000倍,最近六个月又增长了三倍,达到每天500万亿Token。随着AI应用的普及,Token需求仍在持续攀升。与此同时,正如郭威所说,随着智能体的出现,底层算力的需求结构正在改变。
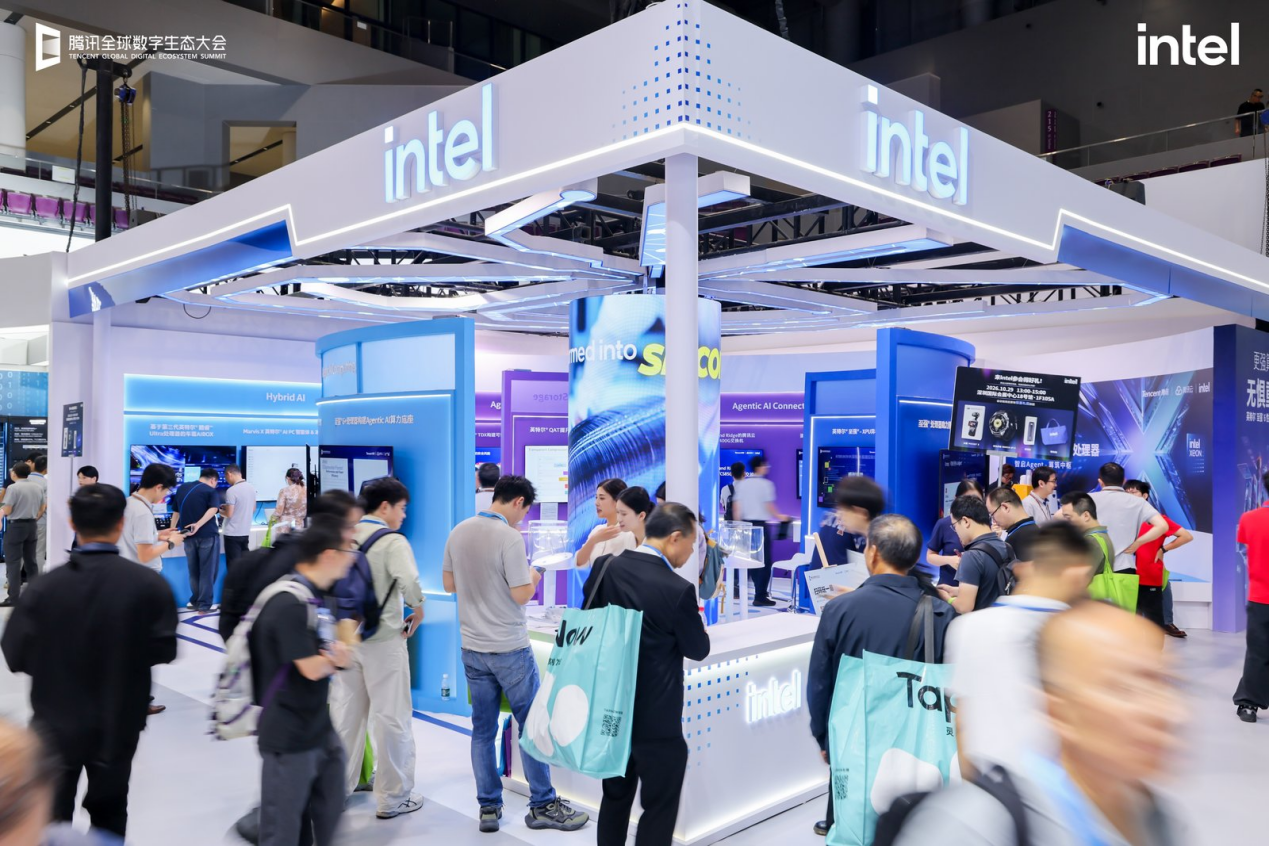
从至强6+处理器、Agent沙箱,到内存压缩、KV Cache存储,再到数据中心GPU和AI PC,英特尔试图在这场题为“智启Agent·算筑中枢”的大会中展示一个更加完整的技术思路:在智能体时代,CPU不再只是GPU的辅助处理器,而是逐渐成为整个AI计算系统的调度中枢。
被智能体改变的底层算力
在训练时代,GPU是当之无愧的主角,这是毋庸置疑的;哪怕进入到Chatbox过去,用户向大模型提出问题,模型完成一次推理便可以给出答案,中间对CPU的牵扯也不是太多;但来到Agentic AI时代,一个用户请求可能会被拆解成多个子任务,智能体需要经历思考、规划、执行、反馈和复盘等多个环节,还要不断调用外部工具、访问数据和执行代码。
这些工作并不全部发生在GPU上。模型推理固然需要GPU,但任务编排、工具调用、数据处理、执行环境管理等环节,都需要CPU参与。这也使得CPU与GPU之间的算力配比成为行业关注的新问题。
郭威在演讲中也提到,过去行业讨论较多的是CPU与GPU 1:8的比例,后来逐渐向1:4变化,而如今越来越多客户开始关注1:1的可能性。当然,我们必须强调一点的是,这并不意味着GPU的重要性下降,而是智能体工作负载的增加,让CPU在整个AI基础设施中的角色发生了变化。
英特尔技术专家在随后的分享中也指出,单轮AI推理主要由GPU承担模型生成任务,CPU更多负责前后端的数据准备与交付。但智能体AI涉及多个连续环节,过去的对话、执行记录以及上下文信息都可能被保留下来。在这个过程中,CPU需要在不同任务之间进行调度,并与GPU交替协同。随着智能体执行链条不断拉长,CPU的参与程度自然会提高。而随着上下文长度、并发用户数量和多轮任务执行不断增长,对KV Cache也提出新的要求。
从大会的介绍我们得知,随着Agentic AI的到来,对云端执行环境提出的新要求,而Agent沙箱就顺势成为一个非常重要的基础设施。
据介绍,对于Agent应用,沙箱并不只是启动速度的问题,因为智能体执行任务的时间可能只有几秒,也可能持续数小时,期间还需要保留上下文和运行状态。因此,如何在隔离性、资源密度、启动速度和状态管理之间取得平衡,将直接影响Agent基础设施的整体成本。智能体在执行代码、调用工具以及进行强化学习评测时,需要大量独立、隔离的执行环境。这些环境不仅要能够快速创建,还要能够在高并发情况下保持稳定。
沙箱以外,内存容量也是Agentic AI基础设施面临的另一项挑战。因为在智能体运行过程中,CPU利用率往往呈现突发式变化:任务启动、控制和调度阶段会出现短时间的计算峰值,进入实际执行阶段后,CPU利用率又可能下降。但与此同时,智能体的运行状态和内存占用却需要持续保持。
英特尔技术专家给出了一个例子:假设每个Agent分配2GB内存,每个线程超配4个Agent,那么每个vCPU就需要8GB内存。如果一颗256核CPU配置12通道内存,每通道使用128GB内存条,折算下来只有6GB/vCPU,仍然存在2GB的容量缺口。
这意味着,即使CPU还有大量计算资源可以利用,内存容量也可能先成为限制Agent高密部署的瓶颈。
全能的至强6+,落地腾讯云
围绕Agentic AI带来的新需求,英特尔带来了新一代旗舰Xeon 6+(Clearwater Forest)。
作为英特尔首款采用Intel 18A工艺制造的数据中心处理器,Xeon 6+最大配置搭载288个Darkmont能效核(E-Core),相比上一代Sierra Forest,单核IPC提升约17%。产品主要面向超大规模云计算、数据中心和网络基础设施等场景,重点提升多线程吞吐量和单位功耗计算性能。在芯片架构方面,Xeon 6+采用多芯粒设计,最多集成12个采用Intel 18A工艺制造的计算芯粒,搭配Intel 7工艺的I/O芯粒和Intel 3工艺的有源基底芯粒,并通过Foveros Direct 3D和EMIB实现芯粒间互连。此外,该处理器支持12通道DDR5-8000内存以及PCIe 5.0、CXL 2.0等技术。
正是看中了这颗处理器的性能,腾讯云与英特尔在此次大会上发布了基于英特尔至强6+处理器的新一代云实例。值得一提的是,这是英特尔至强6+处理器首次在腾讯云实现落地。
根据腾讯云披露的数据,在这个新处理器的支持下,新一代云实例综合性能相比上一代提升30%,腾讯内部业务也将率先使用这款产品,通过真实业务负载持续打磨产品能力和稳定性。
腾讯云高级产品经理夏士悦也透露,针对Agent沙箱场景,腾讯云将200ms作为一个重要的SLA约束,并对下一代至强6+云实例进行了测试。结果显示,至强6+的沙箱并发密度相比业界同类产品高45%,换算到每个vCPU,其沙箱创建吞吐能力提升94%。
在大会现场披露的进一步测试结果显示,至强6+处理器能够支持350个沙箱并发。即使在高负载情况下,处理时延依然保持稳定,沙箱创建的P99时延较低,并且随着并发密度增长,时延上升也相对平缓。即便宿主机同时运行其他负载,并发能力也没有出现明显下降。这背后不仅是处理器性能的提升,也涉及软硬件协同优化。
腾讯云开源项目CubeSandbox采用MicroVM架构,通过独立内核与快照技术,实现执行环境的快速创建和资源复用。多个虚拟机如果基于相同镜像创建,可以共享大量未修改的内存和磁盘资源,只有发生变化的部分才需要额外占用资源。
与此同时,英特尔与腾讯技术团队还对内核路径进行了优化,相关改进也合入了腾讯OpenCloudOS内核,以进一步降低并发启动时延。
除了提高性能以外,英特尔还提出了软硬件协同的内存压缩方案,以破解存储难题。具体而言,方案利用操作系统Zswap机制,对不活跃的内存页面进行压缩,将其释放出来供其他任务使用,需要时再进行解压和加载。英特尔至强6处理器内置的IAA(In-memory Analytics Accelerator)加速器,则可以承担其中的压缩和解压工作。测试显示,与单纯依靠CPU执行LZ4、ZSTD等软件压缩算法相比,IAA能够显著降低CPU占用的同时,提供更快的压缩和解压速度。
腾讯云TencentOS Server产品研发负责人彭浩分享了实际测试结果。据介绍,此前,腾讯云尝试使用LZ4和ZSTD进行内存压缩,但在多路并发解压时,LZ4的最大时延达到5毫秒,难以满足业务需求。其原因在于,压缩解压不仅是CPU计算问题,还涉及大量内存访问。并发任务增加后,内存带宽争抢可能导致内存控制器访存队列拥塞,进而拉高解压时延。
在引入IAA之后,腾讯云通过对原生驱动进行轻量适配,并采用IAA-batch-8的配置方式,显著改善了解压性能。
最终测试显示,相比软件压缩方案,IAA-batch-8可以实现平均时延提升16倍、最大时延提升9倍。尤其是在256路并发的综合压力测试中,软件方案平均耗时达到1毫秒,而IAA方案为56微秒,最大耗时为564微秒。
在笔者看来,这项技术的价值在于,内存压缩不再完全依赖CPU自身的计算资源,而是可以通过专用硬件加速器完成,从而降低内存高密部署的性能损耗。除了IAA,英特尔还提出了通过2DPC内存配置和CXL内存扩展增加系统内存容量的方案,为Agent高密部署提供更多选择。
GPU,没有被忽视
在此次大会上,英特尔专门展示了面向智能体AI的至强6存储平台。其核心思路是通过存算分离架构,将GPU、CPU计算节点与后端存储连接起来,利用RDMA高速网络构建端到端的KV Cache缓存体系,并结合英特尔KV Shrink分层KV软件以及至强6处理器内置的QAT加速器,对KV Cache进行复用和压缩。
根据英特尔公布的测试结果,在KV Cache能够100%命中后端高性能存储的情况下,相比原生vLLM且不进行缓存复用的方案,TTFT(首Token生成时间)可以降低90%。在并发8、16和32的情况下,吞吐量分别提升5倍多、6倍多和8倍多。如果从单机角度出发,考虑GPU缓存和CPU内存容量有限,假设缓存命中率为80%,相比100%命中的后端存储方案,依然能够在不同并发情况下实现接近2倍的吞吐量提升。
此外,在开启QAT压缩后,整体吞吐量没有明显损失,但可用存储容量增加了近20%。
这说明,随着Agentic AI不断发展,存储不再只是负责保存模型数据的基础设施,而是开始直接参与推理性能优化。通过缓存复用、数据压缩和高速存储,减少重复计算,也成为改善AI系统整体效率的重要手段。
在会上,英特尔还展示了在高密度NVMe存储平台上的优化成果。在24盘配置下,经过软硬件协同优化,平台可以达到2.7M IOPS,以满足Agentic AI小I/O、高并发和低时延的需求。
从上面的介绍可以看到,此次大会的主题强调CPU在智能体时代的作用,但英特尔并没有忽视GPU。正如他们所说,随着Agentic AI任务执行时间从过去的几秒延长到几分钟甚至十几分钟,上下文也从1K、4K逐渐向256K、512K乃至1M演进,KV Cache持续增长,对GPU显存容量提出了更高要求。
英特尔在大会上介绍了代号Crescent Island的GPU D系列。
据介绍,这款产品的两大特点是大显存和低功耗,单卡配备最高480GB LPDDR5X内存,功耗约350W。英特尔表示,其无需对现有数据中心进行大规模改造,采用风冷即可部署。在模型支持方面,单张GPU D系列最高可以支持3000亿参数模型运行,八卡系统则可以支持超过1万亿参数模型运行。
在软件方面,英特尔也在持续完善开放软件栈,希望从驱动、算子到中间件提供支持。值得关注的是,英特尔还尝试利用AI Agent和专门的Skill,将CUDA软件迁移到英特尔平台。
其披露的测试显示,选择10个不同项目,通过大模型Skill和Agent进行迁移,基本可以在2小时至十几个小时内完成代码转换,随后再进行算子优化。英特尔估算,相关迁移成本从几十美元到最高130美元不等。
这也是英特尔希望借助AI工具降低软件生态迁移门槛的一种尝试。
写在最后
除了数据中心,英特尔也在大会上分享了公司是如何将Agentic AI能力带入PC。
英特尔在会上提出,智能体时代的PC正在从过去由人操作的生产力工具,转变为智能体执行任务的终端。用户提出需求后,智能体可以完成任务拆解、工具调用和执行交付,人更多是在关键环节进行确认。在这一过程中,英特尔认为,云端和本地并不是替代关系,而是需要形成混合式AI架构:复杂的推理任务可以交给云端,而对时延、隐私和本地资源调用有较高要求的任务,则可以放在PC端完成。
据英特尔介绍,公司推出的第三代酷睿Ultra平台将进一步增强端侧AI能力,并与腾讯WorkBuddy、Marvis等智能体应用展开合作。其中,符合配置要求的Panther Lake设备可以支持WorkBuddy本地模型运行与推理加速。Marvis则通过英特尔本地Skill和隐私模式,为用户提供离线运行、数据不出端的选择。在具体产品上,英特尔展示了与腾讯Marvis合作的本地技能生态,目前已经提供近20个本地Skill;与WorkBuddy合作的方案则引入了30多个本地或混合专家能力。
此外,英特尔还与华硕、飞牛、机械革命等生态伙伴展开合作,涉及商用办公、AI NAS、文件管理、视频处理以及AI游戏助手等应用。从数据中心到PC,英特尔希望将CPU、GPU、存储和软件生态整合起来,为不同场景提供端云协同的AI计算能力。
综上所述,AI基础设施的竞争,正在从单纯追求算力峰值,转向对整个系统执行效率的竞争。 GPU依然是模型计算的核心,但CPU、内存、存储以及网络之间如何协同,将越来越直接地影响智能体的运行成本和用户体验。
对于英特尔而言,Agentic AI带来的变化,或许正是CPU重新确立自身在AI基础设施和PC等端侧设备中地位的一个重要机会。
英特尔市场营销集团副总裁、中国区总经理郭威在日前举办的“腾讯全球数字生态大会英特尔专场”演讲中也指出,中国大模型日均调用量在两年内增长了5000倍,最近六个月又增长了三倍,达到每天500万亿Token。随着AI应用的普及,Token需求仍在持续攀升。与此同时,正如郭威所说,随着智能体的出现,底层算力的需求结构正在改变。
从至强6+处理器、Agent沙箱,到内存压缩、KV Cache存储,再到数据中心GPU和AI PC,英特尔试图在这场题为“智启Agent·算筑中枢”的大会中展示一个更加完整的技术思路:在智能体时代,CPU不再只是GPU的辅助处理器,而是逐渐成为整个AI计算系统的调度中枢。
被智能体改变的底层算力
在训练时代,GPU是当之无愧的主角,这是毋庸置疑的;哪怕进入到Chatbox过去,用户向大模型提出问题,模型完成一次推理便可以给出答案,中间对CPU的牵扯也不是太多;但来到Agentic AI时代,一个用户请求可能会被拆解成多个子任务,智能体需要经历思考、规划、执行、反馈和复盘等多个环节,还要不断调用外部工具、访问数据和执行代码。
这些工作并不全部发生在GPU上。模型推理固然需要GPU,但任务编排、工具调用、数据处理、执行环境管理等环节,都需要CPU参与。这也使得CPU与GPU之间的算力配比成为行业关注的新问题。
郭威在演讲中也提到,过去行业讨论较多的是CPU与GPU 1:8的比例,后来逐渐向1:4变化,而如今越来越多客户开始关注1:1的可能性。当然,我们必须强调一点的是,这并不意味着GPU的重要性下降,而是智能体工作负载的增加,让CPU在整个AI基础设施中的角色发生了变化。
英特尔技术专家在随后的分享中也指出,单轮AI推理主要由GPU承担模型生成任务,CPU更多负责前后端的数据准备与交付。但智能体AI涉及多个连续环节,过去的对话、执行记录以及上下文信息都可能被保留下来。在这个过程中,CPU需要在不同任务之间进行调度,并与GPU交替协同。随着智能体执行链条不断拉长,CPU的参与程度自然会提高。而随着上下文长度、并发用户数量和多轮任务执行不断增长,对KV Cache也提出新的要求。
从大会的介绍我们得知,随着Agentic AI的到来,对云端执行环境提出的新要求,而Agent沙箱就顺势成为一个非常重要的基础设施。
据介绍,对于Agent应用,沙箱并不只是启动速度的问题,因为智能体执行任务的时间可能只有几秒,也可能持续数小时,期间还需要保留上下文和运行状态。因此,如何在隔离性、资源密度、启动速度和状态管理之间取得平衡,将直接影响Agent基础设施的整体成本。智能体在执行代码、调用工具以及进行强化学习评测时,需要大量独立、隔离的执行环境。这些环境不仅要能够快速创建,还要能够在高并发情况下保持稳定。
沙箱以外,内存容量也是Agentic AI基础设施面临的另一项挑战。因为在智能体运行过程中,CPU利用率往往呈现突发式变化:任务启动、控制和调度阶段会出现短时间的计算峰值,进入实际执行阶段后,CPU利用率又可能下降。但与此同时,智能体的运行状态和内存占用却需要持续保持。
英特尔技术专家给出了一个例子:假设每个Agent分配2GB内存,每个线程超配4个Agent,那么每个vCPU就需要8GB内存。如果一颗256核CPU配置12通道内存,每通道使用128GB内存条,折算下来只有6GB/vCPU,仍然存在2GB的容量缺口。
这意味着,即使CPU还有大量计算资源可以利用,内存容量也可能先成为限制Agent高密部署的瓶颈。
全能的至强6+,落地腾讯云
围绕Agentic AI带来的新需求,英特尔带来了新一代旗舰Xeon 6+(Clearwater Forest)。
作为英特尔首款采用Intel 18A工艺制造的数据中心处理器,Xeon 6+最大配置搭载288个Darkmont能效核(E-Core),相比上一代Sierra Forest,单核IPC提升约17%。产品主要面向超大规模云计算、数据中心和网络基础设施等场景,重点提升多线程吞吐量和单位功耗计算性能。在芯片架构方面,Xeon 6+采用多芯粒设计,最多集成12个采用Intel 18A工艺制造的计算芯粒,搭配Intel 7工艺的I/O芯粒和Intel 3工艺的有源基底芯粒,并通过Foveros Direct 3D和EMIB实现芯粒间互连。此外,该处理器支持12通道DDR5-8000内存以及PCIe 5.0、CXL 2.0等技术。
正是看中了这颗处理器的性能,腾讯云与英特尔在此次大会上发布了基于英特尔至强6+处理器的新一代云实例。值得一提的是,这是英特尔至强6+处理器首次在腾讯云实现落地。
根据腾讯云披露的数据,在这个新处理器的支持下,新一代云实例综合性能相比上一代提升30%,腾讯内部业务也将率先使用这款产品,通过真实业务负载持续打磨产品能力和稳定性。
腾讯云高级产品经理夏士悦也透露,针对Agent沙箱场景,腾讯云将200ms作为一个重要的SLA约束,并对下一代至强6+云实例进行了测试。结果显示,至强6+的沙箱并发密度相比业界同类产品高45%,换算到每个vCPU,其沙箱创建吞吐能力提升94%。
在大会现场披露的进一步测试结果显示,至强6+处理器能够支持350个沙箱并发。即使在高负载情况下,处理时延依然保持稳定,沙箱创建的P99时延较低,并且随着并发密度增长,时延上升也相对平缓。即便宿主机同时运行其他负载,并发能力也没有出现明显下降。这背后不仅是处理器性能的提升,也涉及软硬件协同优化。
腾讯云开源项目CubeSandbox采用MicroVM架构,通过独立内核与快照技术,实现执行环境的快速创建和资源复用。多个虚拟机如果基于相同镜像创建,可以共享大量未修改的内存和磁盘资源,只有发生变化的部分才需要额外占用资源。
与此同时,英特尔与腾讯技术团队还对内核路径进行了优化,相关改进也合入了腾讯OpenCloudOS内核,以进一步降低并发启动时延。
除了提高性能以外,英特尔还提出了软硬件协同的内存压缩方案,以破解存储难题。具体而言,方案利用操作系统Zswap机制,对不活跃的内存页面进行压缩,将其释放出来供其他任务使用,需要时再进行解压和加载。英特尔至强6处理器内置的IAA(In-memory Analytics Accelerator)加速器,则可以承担其中的压缩和解压工作。测试显示,与单纯依靠CPU执行LZ4、ZSTD等软件压缩算法相比,IAA能够显著降低CPU占用的同时,提供更快的压缩和解压速度。
腾讯云TencentOS Server产品研发负责人彭浩分享了实际测试结果。据介绍,此前,腾讯云尝试使用LZ4和ZSTD进行内存压缩,但在多路并发解压时,LZ4的最大时延达到5毫秒,难以满足业务需求。其原因在于,压缩解压不仅是CPU计算问题,还涉及大量内存访问。并发任务增加后,内存带宽争抢可能导致内存控制器访存队列拥塞,进而拉高解压时延。
在引入IAA之后,腾讯云通过对原生驱动进行轻量适配,并采用IAA-batch-8的配置方式,显著改善了解压性能。
最终测试显示,相比软件压缩方案,IAA-batch-8可以实现平均时延提升16倍、最大时延提升9倍。尤其是在256路并发的综合压力测试中,软件方案平均耗时达到1毫秒,而IAA方案为56微秒,最大耗时为564微秒。
在笔者看来,这项技术的价值在于,内存压缩不再完全依赖CPU自身的计算资源,而是可以通过专用硬件加速器完成,从而降低内存高密部署的性能损耗。除了IAA,英特尔还提出了通过2DPC内存配置和CXL内存扩展增加系统内存容量的方案,为Agent高密部署提供更多选择。
GPU,没有被忽视
在此次大会上,英特尔专门展示了面向智能体AI的至强6存储平台。其核心思路是通过存算分离架构,将GPU、CPU计算节点与后端存储连接起来,利用RDMA高速网络构建端到端的KV Cache缓存体系,并结合英特尔KV Shrink分层KV软件以及至强6处理器内置的QAT加速器,对KV Cache进行复用和压缩。
根据英特尔公布的测试结果,在KV Cache能够100%命中后端高性能存储的情况下,相比原生vLLM且不进行缓存复用的方案,TTFT(首Token生成时间)可以降低90%。在并发8、16和32的情况下,吞吐量分别提升5倍多、6倍多和8倍多。如果从单机角度出发,考虑GPU缓存和CPU内存容量有限,假设缓存命中率为80%,相比100%命中的后端存储方案,依然能够在不同并发情况下实现接近2倍的吞吐量提升。
此外,在开启QAT压缩后,整体吞吐量没有明显损失,但可用存储容量增加了近20%。
这说明,随着Agentic AI不断发展,存储不再只是负责保存模型数据的基础设施,而是开始直接参与推理性能优化。通过缓存复用、数据压缩和高速存储,减少重复计算,也成为改善AI系统整体效率的重要手段。
在会上,英特尔还展示了在高密度NVMe存储平台上的优化成果。在24盘配置下,经过软硬件协同优化,平台可以达到2.7M IOPS,以满足Agentic AI小I/O、高并发和低时延的需求。
从上面的介绍可以看到,此次大会的主题强调CPU在智能体时代的作用,但英特尔并没有忽视GPU。正如他们所说,随着Agentic AI任务执行时间从过去的几秒延长到几分钟甚至十几分钟,上下文也从1K、4K逐渐向256K、512K乃至1M演进,KV Cache持续增长,对GPU显存容量提出了更高要求。
英特尔在大会上介绍了代号Crescent Island的GPU D系列。
据介绍,这款产品的两大特点是大显存和低功耗,单卡配备最高480GB LPDDR5X内存,功耗约350W。英特尔表示,其无需对现有数据中心进行大规模改造,采用风冷即可部署。在模型支持方面,单张GPU D系列最高可以支持3000亿参数模型运行,八卡系统则可以支持超过1万亿参数模型运行。
在软件方面,英特尔也在持续完善开放软件栈,希望从驱动、算子到中间件提供支持。值得关注的是,英特尔还尝试利用AI Agent和专门的Skill,将CUDA软件迁移到英特尔平台。
其披露的测试显示,选择10个不同项目,通过大模型Skill和Agent进行迁移,基本可以在2小时至十几个小时内完成代码转换,随后再进行算子优化。英特尔估算,相关迁移成本从几十美元到最高130美元不等。
这也是英特尔希望借助AI工具降低软件生态迁移门槛的一种尝试。
写在最后
除了数据中心,英特尔也在大会上分享了公司是如何将Agentic AI能力带入PC。
英特尔在会上提出,智能体时代的PC正在从过去由人操作的生产力工具,转变为智能体执行任务的终端。用户提出需求后,智能体可以完成任务拆解、工具调用和执行交付,人更多是在关键环节进行确认。在这一过程中,英特尔认为,云端和本地并不是替代关系,而是需要形成混合式AI架构:复杂的推理任务可以交给云端,而对时延、隐私和本地资源调用有较高要求的任务,则可以放在PC端完成。
据英特尔介绍,公司推出的第三代酷睿Ultra平台将进一步增强端侧AI能力,并与腾讯WorkBuddy、Marvis等智能体应用展开合作。其中,符合配置要求的Panther Lake设备可以支持WorkBuddy本地模型运行与推理加速。Marvis则通过英特尔本地Skill和隐私模式,为用户提供离线运行、数据不出端的选择。在具体产品上,英特尔展示了与腾讯Marvis合作的本地技能生态,目前已经提供近20个本地Skill;与WorkBuddy合作的方案则引入了30多个本地或混合专家能力。
此外,英特尔还与华硕、飞牛、机械革命等生态伙伴展开合作,涉及商用办公、AI NAS、文件管理、视频处理以及AI游戏助手等应用。从数据中心到PC,英特尔希望将CPU、GPU、存储和软件生态整合起来,为不同场景提供端云协同的AI计算能力。
综上所述,AI基础设施的竞争,正在从单纯追求算力峰值,转向对整个系统执行效率的竞争。 GPU依然是模型计算的核心,但CPU、内存、存储以及网络之间如何协同,将越来越直接地影响智能体的运行成本和用户体验。
对于英特尔而言,Agentic AI带来的变化,或许正是CPU重新确立自身在AI基础设施和PC等端侧设备中地位的一个重要机会。
责任编辑:SemiInsights
相关文章
-
- 半导体行业观察
-
- 摩尔芯闻
最新新闻
热门文章 本日 七天 本月
热门评论
©2025 半导体行业观察
Copyright©2023 芯算智能科技(扬州)有限公司
苏ICP备2025200240号-2 皖公网安备 34019202000656号