Diamond Rapids背后,英特尔重构Agent时代CPU!
2026-09-28
13:06:54
来源: 杜芹
点击
一个月前的Hot Chips 2026上,英特尔正式公布了下一代至强处理器Diamond Rapids:最高256个核心、1.28GB末级缓存、16通道DDR5/MRDIMM、128条PCIe 6.0,并引入APX、增强版AMX以及Foveros Direct 3D封装。
作为英特尔下一代高性能至强平台,Diamond Rapids受到业界广泛关注。
在9月23日举行的2026云栖大会上,英特尔进一步介绍了这颗处理器的架构设计,并围绕Agentic AI时代数据中心基础设施的变化展开讨论。
其中一个重要判断是:随着AI从单轮模型推理逐渐进入多轮、长链路的Agent工作流,数据中心对CPU的需求正在发生变化。GPU依然承担最核心的模型计算,但任务编排、数据处理、存储访问、工具调用和系统调度等负载正在显著增加,CPU的重要性也随之上升。
一、架构范式转移:CPU 强势重返算力“C 位”
2026年,AI产业正式跨入“智能体(AI Agent)元年”。大模型不再仅仅是停留在对话框里的“聊天工具”,而是开始深入企业级业务场景,演化为能够理解上下文、调用工具并自主执行复杂任务的生产力引擎。
AI智能体概念的爆发并非仅仅停留在应用层的狂欢,其背后是庞大且明确的算力与基础设施需求支撑。英特尔数据中心集团副总裁、中国区总经理陈葆立援引了一系列震撼的行业数据,勾勒出了Agent时代的增长陡峭曲线。
l 预计到2026年底,全球超过80%的企业应用将至少嵌入一个AI智能体。IDC预测,到2031年,仅中国企业场景中的活跃AI智能体数量就将高达3.5亿个;
l 国内大模型的日均Token调用量正呈现出惊人的爆发力,相较于2024年初,如今的调用规模已暴增5000倍;
l 在底层支撑方面,2026年全球优化型IaaS支出预计将实现96%的同比高速增长。而据美银证券预测,到2029年,中国AI数据中心的固定资产投资规模将突破2.2万亿元人民币。
随着AI智能体的全面渗透,数据中心的工作负载特征正在被彻底改写。业界预测,到2030年,数据中心80%的工作负载都将与AI高度相关。基于此,英特尔提出必须重新审视AI数据中心的系统级架构。
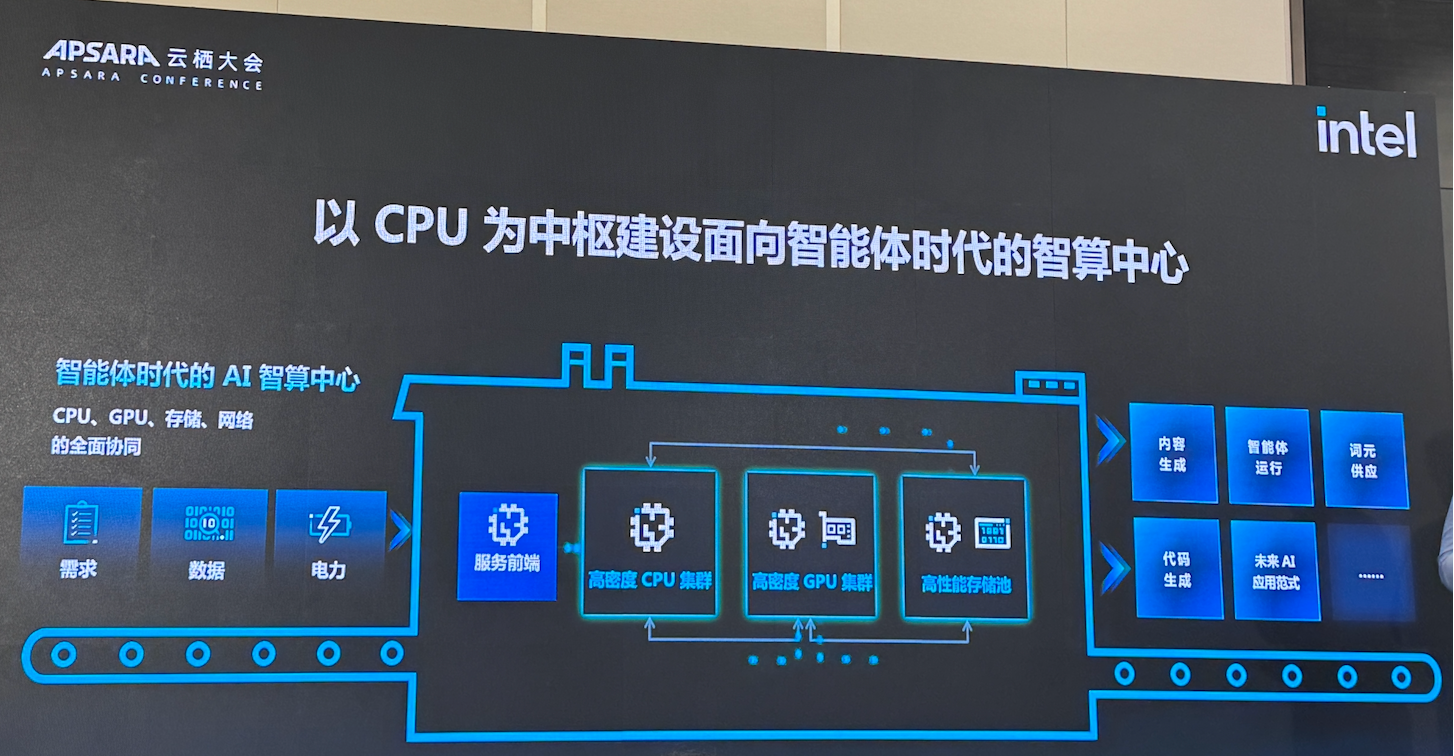
英特尔认为,未来AI数据中心可以大致分为三类核心资源:CPU集群负责Agent任务执行、工作流编排以及通用数据处理;GPU及AI加速器负责高强度模型计算;存储集群则负责模型、上下文、向量数据以及KV Cache等海量数据的保存与调用。
阿里云智能集团资源总监、首席服务器架构师卓久也指出,当前AI数据中心需要从单纯关注GPU,转向对整个系统瓶颈的重新审视。从GPU、CPU到内存、存储,从硬件到软件,都需要进行协同设计。
对于市场上流行的“Agentic CPU”概念,卓久则给出了更加谨慎的判断。现阶段通用CPU在Agent工作流的编排、调度以及复杂控制流处理中本身就具有优势,因此Agent应用增长自然会放大CPU需求。但这并不意味着现有CPU从一开始就是为Agent量身设计的。真正从底层微架构层面针对Agent工作流进行系统性优化的处理器,可能仍处于更早期的产品研发阶段。
英特尔技术专家李尔成也指出,AI应用正在从传统单轮推理走向Agentic多轮工作流,由此改变数据中心内部CPU与GPU的资源配比。部分AI系统中CPU与GPU的比例正在从传统的1:4逐渐向1:1靠近;在一些高度依赖Agent流控和任务编排的场景中,CPU资源需求甚至可能超过GPU。
这种变化并不意味着CPU要替代GPU,而是AI系统中越来越多工作已经超出纯粹的模型计算。在Agentic AI场景下的MoE负载不均衡和KV Cache搬移这两个环境中,CPU可以成为GPU的重要补充。
首先先是在MoE场景中承担“弹性算力池”的角色。当部分热点专家超过GPU负载上限时,与其频繁在不同GPU之间迁移权重,不如将少量溢出的热点专家交给CPU处理。CPU虽然在内存带宽上不及GPU,但拥有更大的内存容量,同时AMX也提供了较强的矩阵计算能力,因此在只承载少量溢出专家时,可以发挥“容量大、算力强”的优势,帮助GPU实现更灵活的异构负载均衡。
另一个重点是KV Cache分层复用。KV Cache虽然能够“以存代算”,但规模越大,对DRAM和SSD容量以及数据搬移效率的要求也越高。针对这一问题,英特尔提出利用至强平台中的DSA和QAT进行优化:DSA负责加速大量小块KV Cache在CPU内存与GPU之间的搬移,同时避免额外占用CPU和GPU计算资源;QAT则负责压缩KV Cache,以降低内存和SSD压力。按照英特尔现场公布的数据,KV Cache压缩幅度可达到20%—30%,同时首Token时延没有明显损失。
其核心思路并不是让CPU替代GPU,而是在GPU最容易出现资源失衡和数据搬移瓶颈的地方,引入CPU及专用加速器承担辅助角色。随着Agent模型规模扩大,CPU、GPU、内存与存储之间的协同,正在成为推理效率优化的重要方向。
二、硬件重器:下一代至强Diamond Rapids(DMR)微架构剖析
在产品路线上,英特尔展现出了极强的节奏感。继2025年推出的主打性能核的至强6及2026年6月发布基于 Intel 18A 制程主打能效核的至强 6+(Clearwater Forest)之后,英特尔针对 Agentic AI 的高并发与内存墙痛点,推出了全新一代至强处理器——代号 Diamond Rapids(DMR),这堪称一款在微架构层面真正瞄准Agentic AI痛点设计的算力核芯。
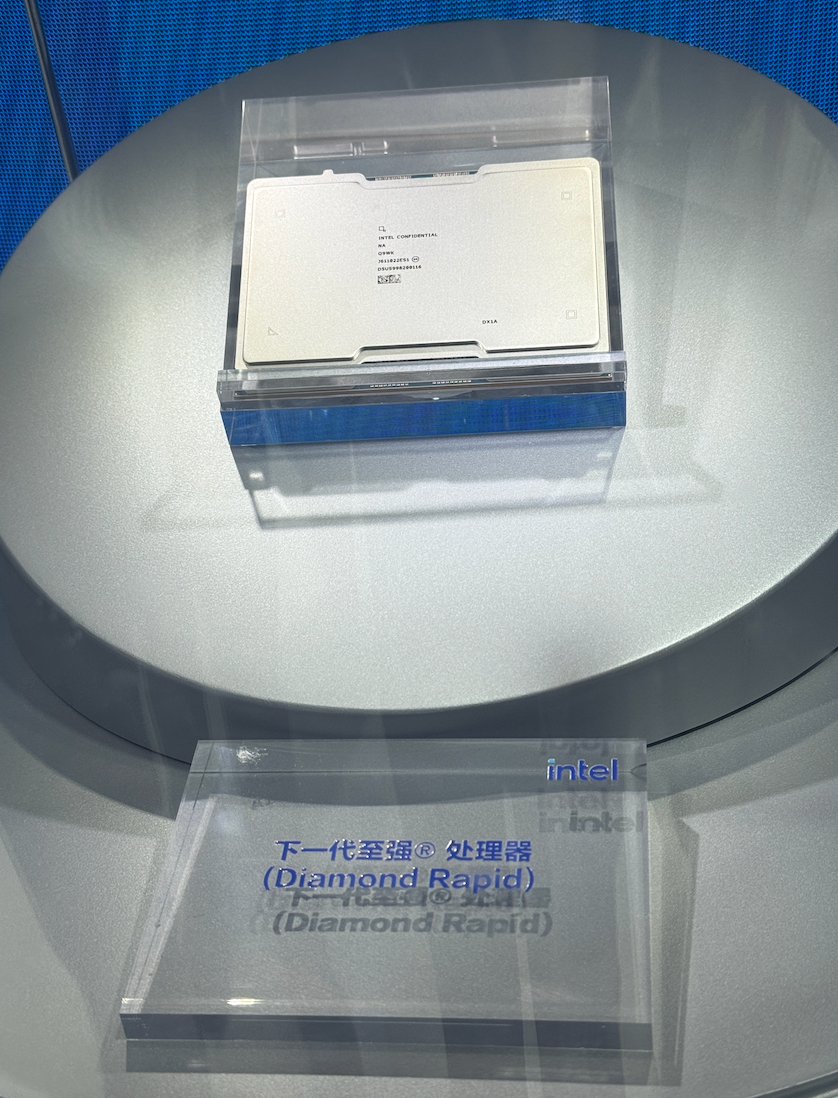
从目前公布的架构信息来看,Diamond Rapids的重点并不是简单增加核心数量,而是针对高并发、内存带宽、数据移动和系统I/O等问题进行整体升级。
其最高支持256个核心,配备增强版AMX和AVX 10.2指令集,并支持FP8、FP16、BF16等AI常用数据格式。在存储体系方面,其末级缓存最高达到1.28GB,配合16通道内存以及最高12800MT/s的MRDIMM,系统内存带宽最高达到约1.6TB/s。在I/O方面,Diamond Rapids提供128条PCIe 6.0通道,并继续集成QAT、DSA、IAA等专用加速能力。
英特尔技术专家龚海峰从Agent工作流中的系统性能出发,对Diamond Rapids的微架构变化进行了进一步解释。
在智能体工作流中,CPU与GPU高度交织且存在强前后依赖——CPU上的每一毫秒延迟,都会直接转化为GPU的空闲等待时间。评估CPU性能的关键指标,在于“单智能体完成端到端任务的总耗时”与“单位时间内系统可承载的并发智能体数量”。基于这一需求,英特尔提炼出了智能体场景下的CPU性能公式:
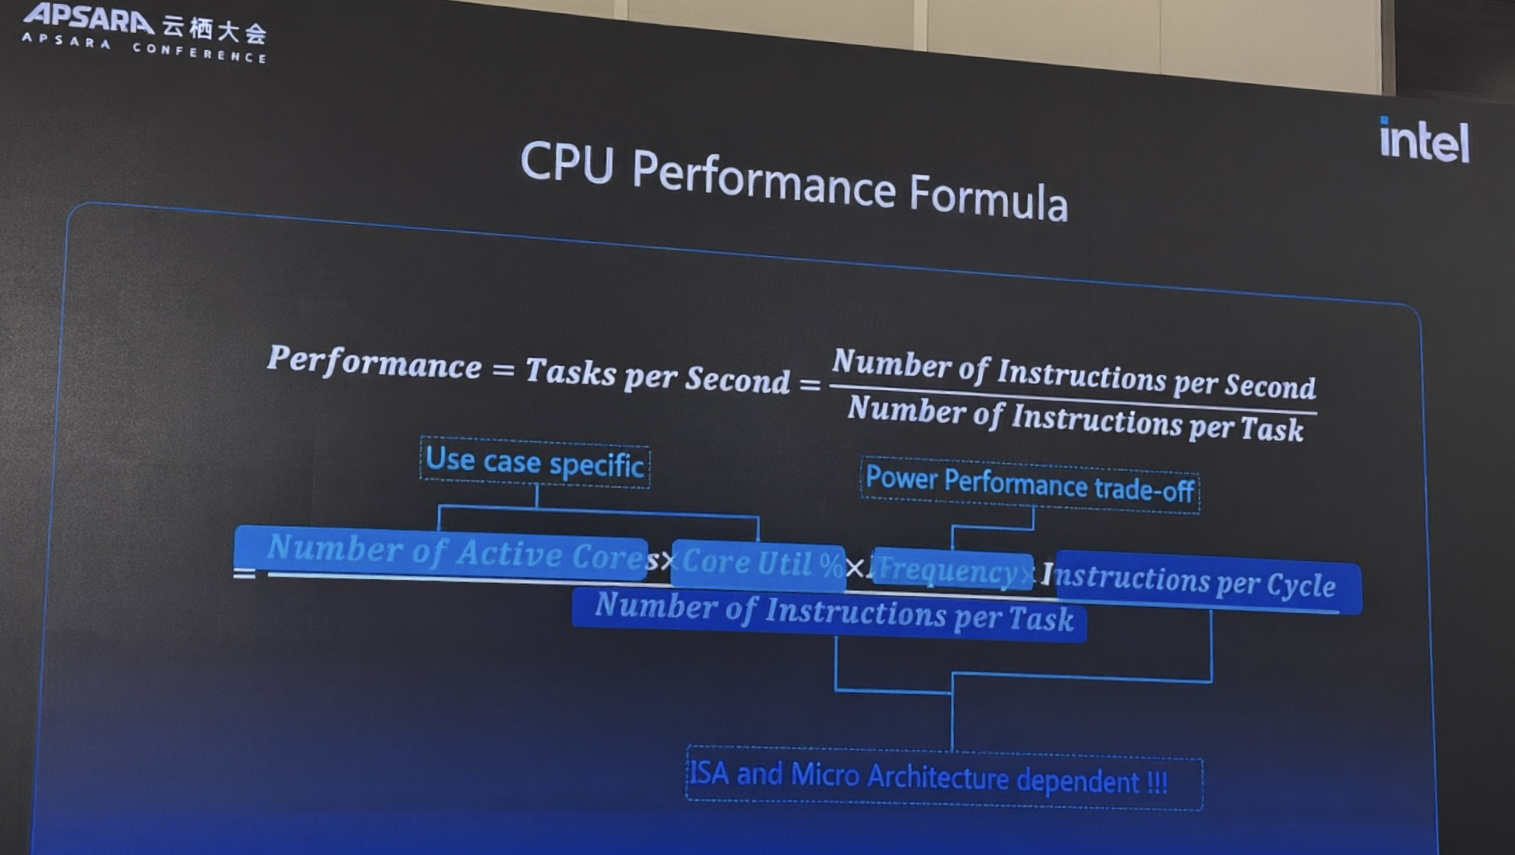
在频率与核心数遭遇物理功耗墙的当下,提升性能的唯一突破口在于:提高每时钟周期指令数(IPC),同时极致压缩完成单任务所需的总指令数。为实现这一目标,Diamond Rapids引入了x86架构近年来极具颠覆性的底层革新——APX(Advanced Performance Extensions)指令集。
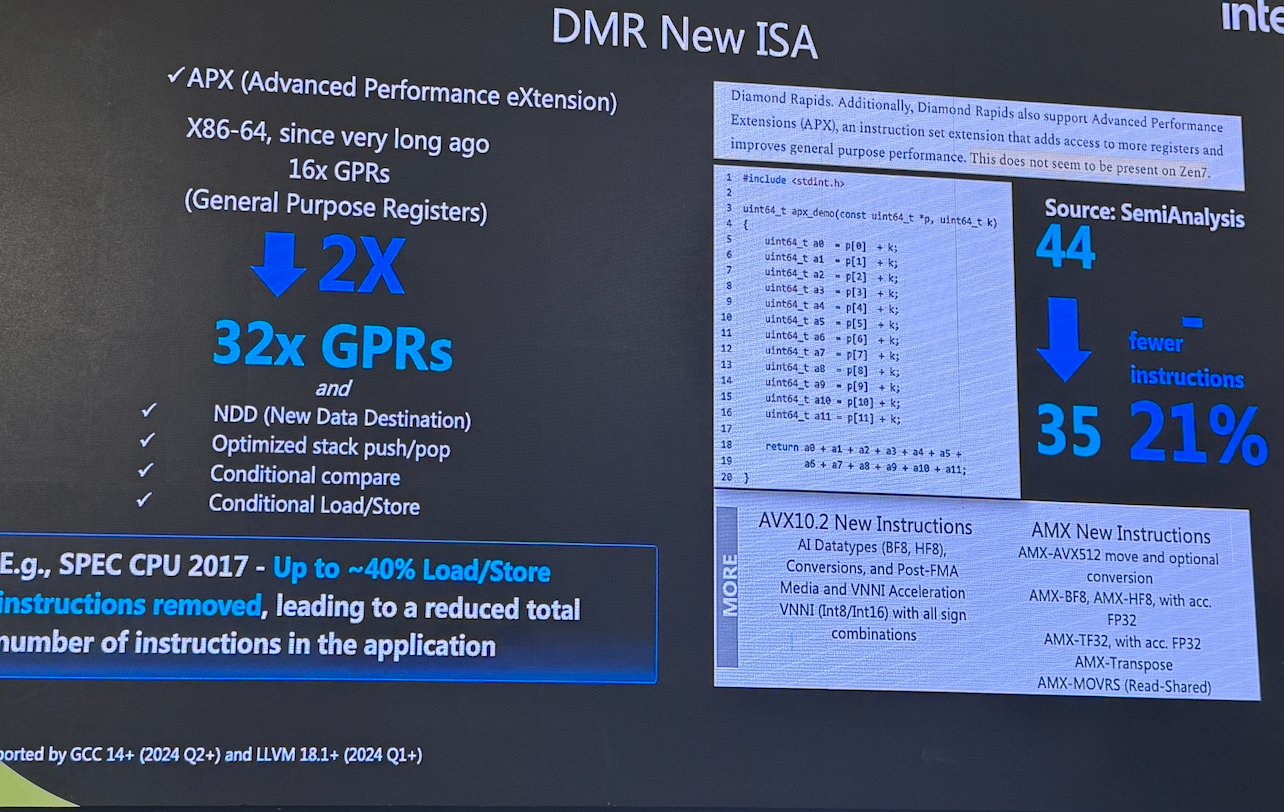
APX首先将x86通用寄存器从16个扩展到32个。寄存器数量增加后,可以有更多临时数据保留在CPU内部,从而减少数据在寄存器和内存之间反复搬运。
同时,APX还引入NDD(New Data Destination)。传统x86执行类似“A=A+B”的操作时,计算结果会覆盖A。如果后续程序仍需要原始A,就需要额外进行保存。NDD则允许直接执行“C=A+B”,减少一部分额外的数据复制和指令。按照英特尔现场展示的数据,在部分经过APX编译器优化的SPEC CPU 2017代码中,Load/Store指令数量可以减少约40%。
与此同时,Diamond Rapids在芯片封装和内部拓扑上也进行了明显调整。
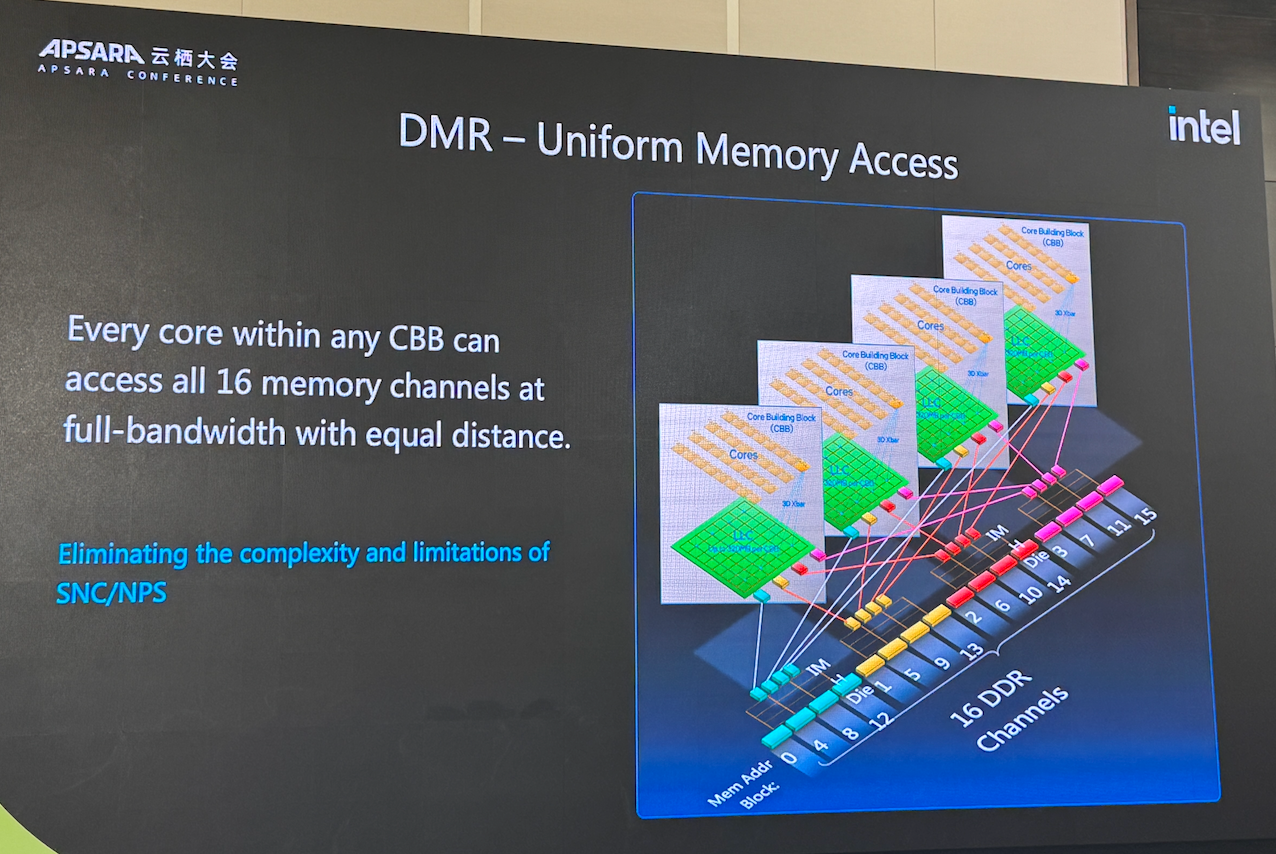
DMR采用新的Fan-out Fabric架构。整个SoC以两个Fabric Hub Die为中心,负责提供内存和I/O接口,周围分布四个CBB,也就是计算与缓存模块。让不同计算模块能够以相对均衡的路径访问内存和PCIe资源,降低不同芯粒之间访问延迟的差异,同时减少复杂NUMA拓扑给软件调度带来的负担。
Diamond Rapids同时采用3D垂直封装,将大容量SRAM与计算核心进一步靠近。根据英特尔披露的信息,每个相关计算模块下方集成约320MB SRAM,最终整颗处理器的L3缓存最高达到1.28GB。这意味着高端服务器CPU的末级缓存容量开始进入GB级。
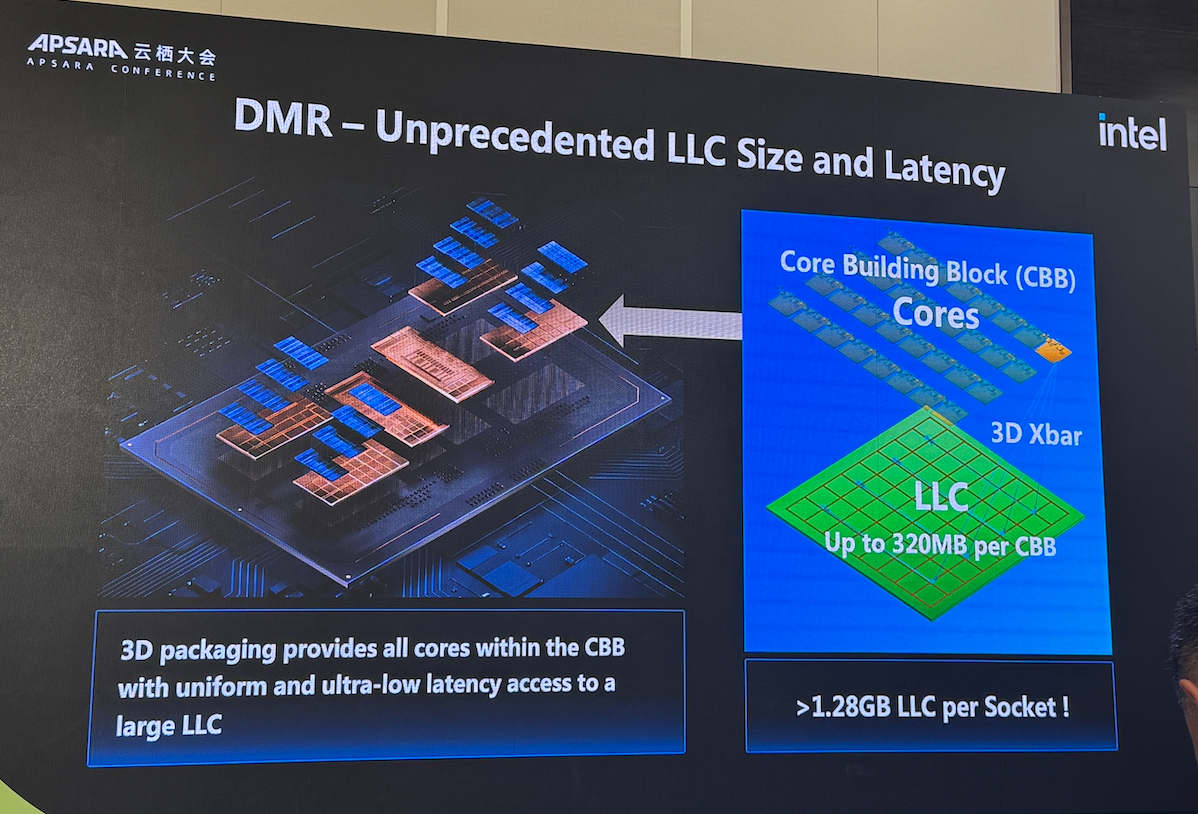
对于Agent工作负载而言,更大的缓存可以让更多状态、元数据和热点数据停留在片上,减少CPU频繁访问DRAM。配合UCIe互连、16通道内存以及MRDIMM,Diamond Rapids系统内存带宽最高达到约1.6TB/s。
除了计算和内存,Diamond Rapids也进一步加强了系统I/O能力。在典型八卡GPU服务器中,往往采用双路CPU架构。当GPU进行All-to-All集合通信或跨插槽访问数据时,如果CPU之间以及CPU与GPU之间的互连带宽不足,就可能造成通信拥塞。Diamond Rapids提供128条PCIe 6.0通道,并支持双路平台之间配置多条高速x16互连链路,以提高跨插槽和设备之间的数据传输能力。
英特尔还希望结合处理器内部的遥测能力、余量感知路由和硬件加速器卸载,在满足P99时延和SLA要求的情况下,提高单节点能够稳定承载的Agent数量。
三、软件进化:四大工程重定义底层算力
过去一年里,诸如通义千问办公等各类AI工具如雨后春笋般涌现,用户直观感受到的是“AI越来越好用”,但在这背后,实则是AI软件层面的四次深度演进,这也被陈葆立归纳为四大工程阶段:
Prompt Engineering(提示词工程):人机交互的起点。
Context Engineering(上下文工程):解决大模型“记忆力缺失”的痛点,让原本“没有记忆的天才”能够处理和关联海量背景信息。
Harness Engineering(工具链工程):赋予AI智能体调用外部工具、执行实际任务的“手脚”。
Loop Engineering(闭环工程):这是智能体走向成熟的关键。AI不再只是被动应答,而是像一个严谨的学者,在输出结果后会自主进行重新验算、检查与逻辑自洽,确保最终答案精确契合用户需求。
正是这层层递进的软件创新,直接引发了底层算力结构的质变。从复杂的上下文检索、外部工具的API调度,到多轮逻辑闭环的验算与编排,这些任务极其依赖通用计算能力。这也就是为什么在智能体时代,CPU的重要性不降反升——庞大而繁杂的工作流编排与预处理,需要消耗海量的CPU资源。
除了为Agent提供底层算力,英特尔也在尝试反过来利用AI Agent解决GPU软件生态迁移问题。英特尔技术专家汪洋指出,当前大多数AI开发仍然围绕英伟达CUDA生态展开,而真正困难的并不是API转换本身,而是不同GPU微架构带来的性能差异。传统静态转换工具虽然能够把CUDA代码翻译成其他编程接口,但往往只能解决“能不能运行”的问题,很难保证迁移后的性能。
英特尔的思路,是把代码迁移从简单的语法转换升级为由AI Agent驱动的完整工程流程。其基础是英特尔长期推动的开放软件栈:从vLLM、SGLang等上层推理框架,到PyTorch、Triton、SYCL以及通信和高性能计算库,英特尔希望尽量保持与主流AI生态兼容。与此同时,SYCL基于C++,经过多年发展,已经被大量代码和模型数据覆盖,这也为大模型理解和生成SYCL代码提供了基础。
在实际迁移过程中,AI Agent首先理解CUDA代码背后的算法意图,再重新生成适配英特尔GPU的代码;随后通过性能分析工具读取硬件运行指标,识别性能瓶颈,并结合英特尔提供的微架构优化经验继续自动调优。也就是说,代码生成、编译、验证、性能分析和优化,可以被串成一个自动化闭环。
英特尔公布的一组测试显示,其从开源社区选择了10个项目、共468个算子进行迁移,其中445个完成迁移,完成度约95%;平均单个算子交付成本约0.6美元,耗时约7.9分钟。进一步在Llama.cpp上测试时,AI Agent自动迁移了107个算子,并新增支持17个此前未覆盖的算子。经过后续性能优化后,其中45个算子的性能超过了原有人工编写版本。
这套方法指向的并不只是“把CUDA代码搬到英特尔GPU上”,而是试图降低不同GPU架构之间的软件迁移成本。如果AI Agent能够承担越来越多的代码适配和性能调优工作,那么未来企业选择AI加速器时,软件生态带来的锁定效应可能会有所减弱,硬件之间的竞争也会更多回到性能、成本和整体系统效率本身。
四、云端全栈落地:阿里云与英特尔的软硬协同范式
从实际落地来看,阿里云与英特尔的合作提供了一个较为完整的软硬协同案例。
双方的合作并不是从Agent时代才开始。
早在Sapphire Rapids时期,阿里就在搜索推广场景中尝试CPU与GPU异构计算。尤其是在“双十一”等高峰流量场景下,搜索推广业务中大量Embedding任务运行在CPU侧,而计算更加密集的部分则运行在GPU侧,两类计算资源之间还需要持续进行数据交换。
Sapphire Rapids引入AMX之后,为CPU侧AI计算提供了新的加速能力。因此,在Sapphire Rapids推出早期,阿里就将其部署到“双十一”主搜索推理场景,并围绕算子和模型进行了大量迁移和调整。英特尔工程团队也参与了相关优化。这次合作验证了AMX在大规模线上业务中的可用性,也成为双方后续继续深化软硬协同的重要基础。
进入Agentic AI阶段之后,合作范围进一步扩大到云服务器、块存储、数据库、AI推理以及端侧计算等多个层面。
目前,阿里云基于英特尔平台的九代实例已经形成千万核规模,并成为承载Agent应用的重要基础设施之一。九代实例采用英特尔至强6处理器,并根据不同Agent负载进行产品化设计。例如,重负载Agent、高并发浏览器Agent、RAG、大内存应用以及工具调用,对算力、内存、I/O和启动速度的需求都存在差异,因此阿里基于同一平台衍生出了多种实例形态。
阿里并没有只使用至强6的通用CPU性能,而是进一步利用AMX、QAT、IAA、DSA等专用加速能力。其中,AMX用于FP16计算、向量检索和Embedding等任务;QAT用于数据压缩;IAA则可以用于快照压缩和解压缩,从而缩短沙箱启动时间。
这些实践体现出Agent负载的一个重要特点:峰值突发性较强,同时任务链长、资源需求不确定,因此底层基础设施不仅要追求峰值性能,还需要同时考虑弹性和成本。
双方在存储领域的合作进一步体现了这种软硬协同。
阿里云磐久九代存储服务器围绕英特尔至强6进行了多项微架构级优化。在数据链路上,阿里利用DDIO让PCIe设备的数据直接进入末级缓存,减少DRAM访问;利用DSA卸载数据搬移和CRC校验,让CPU更多用于任务调度;同时通过CPU指令集优化纠删编码等计算任务。经过这些优化,阿里披露其单线程能力提升超过40%。
在压缩环节,双方进一步引入QAT。传统软件压缩不仅消耗大量CPU资源,还需要进行CRC校验、解压验证等步骤。通过软硬件联合优化,其中部分工作可以交给硬件加速器完成。阿里公布的测试结果显示,压缩带宽提升约400%,参与压缩任务的CPU核心数量降低75%。如果把上一代平台整体性能定义为1,仅通过新一代硬件升级,吞吐可以提升到约1.5倍;进一步加入软硬协同优化后,整体吞吐可以达到约4倍。目前,这些优化已经在阿里云存储生产环境中大规模部署。
除了云服务器和存储,双方也开始围绕Agent执行环境进行优化。
大量Agent任务需要调用浏览器完成网页访问、表单操作以及跨站业务流程,但传统Chromium浏览器主要围绕人类交互设计,其中包含大量桌面UI和交互模块,在大规模Agent并发场景下会带来较高的内存和资源开销。
为此,阿里云与英特尔围绕Agentic Browser进行了轻量化优化。其基本思路是保留Blink渲染引擎和V8 JavaScript引擎,减少与桌面UI和人工交互相关的模块,再将裁剪后的浏览器能力以预编译SDK方式部署到阿里云弹性算力基础设施。在硬件侧,则结合AVX-512、IAA和QAT等能力,加速脚本执行、数据处理和内存压缩。
根据现场披露的数据,优化后单个Agent实例的常驻内存开销降低约30%,从而提高同一资源池中可同时运行的浏览器实例数量。
Agentic Browser还引入了“双环”机制。首次执行时,由主Agent负责完成推理、规划和流程探索;流程一旦成功,可以进一步沉淀为可复用的RPA自动化工作流。后续执行相同任务时,可以直接重放脚本,只有出现异常情况时才重新调用主Agent进行规划。
按照现场测试数据,这种方式在部分重复性任务中可以显著减少模型推理次数和Token消耗。相较于每一步都重新调用大模型,“AI负责规划、自动化系统负责重复执行”的模式,更适合企业级Agent对于稳定性和成本的要求。
双方合作还在从CPU向GPU以及更大规模的AI系统延伸。
阿里方面提到,在导入包括英特尔GPU在内的新加速器时,评估标准已经不再局限于单颗芯片的理论性能,而是进一步覆盖Profiler、质量检测、故障诊断、微架构分析和性能评测等完整软件工具链。
甚至在硬件实物到位之前,就可以基于GPU微架构开展Cycle级仿真,通过寄存器、共享内存、L2、HBM等多级存储结构,对任务切分、执行顺序以及计算与访存之间的竞争进行分析,从而提前缩小优化空间。
在更长期的系统架构上,阿里也在推进AL144、AL64等超节点,并计划进一步与英特尔CPU平台进行联合调优。
面对更大规模的MoE模型以及更加严格的推理SLA,仅依赖传统单机或者PCIe扩展已经难以满足全部需求。
未来甚至可能根据Attention和FFN不同阶段对于算力、内存和带宽的不同需求,选择不同类型的处理器构建异构超节点。
从这些合作可以看到,阿里与英特尔之间的关系已经不再是简单的CPU采购。过去云厂商选择CPU,核心关注的是核心数量、频率、内存带宽以及单位成本;而到了AI时代,仅靠单颗芯片已经越来越难决定最终系统性能。模型、编译器、算子、存储、网络、服务器架构以及真实业务负载,都需要围绕硬件进行协同优化。
结语
AI Agent 元年的到来,宣告了数据中心单纯堆叠 GPU 峰值算力时代的结束。未来的算力版图不再是单一生态的独角戏,而是一场涵盖 CPU 调度编排、GPU 密集计算、智能体代码重构以及云端场景微创新的全栈协同演进。我们也期待英特尔Diamond Rapid所带来的更多可能性。
作为英特尔下一代高性能至强平台,Diamond Rapids受到业界广泛关注。
在9月23日举行的2026云栖大会上,英特尔进一步介绍了这颗处理器的架构设计,并围绕Agentic AI时代数据中心基础设施的变化展开讨论。
其中一个重要判断是:随着AI从单轮模型推理逐渐进入多轮、长链路的Agent工作流,数据中心对CPU的需求正在发生变化。GPU依然承担最核心的模型计算,但任务编排、数据处理、存储访问、工具调用和系统调度等负载正在显著增加,CPU的重要性也随之上升。
一、架构范式转移:CPU 强势重返算力“C 位”
2026年,AI产业正式跨入“智能体(AI Agent)元年”。大模型不再仅仅是停留在对话框里的“聊天工具”,而是开始深入企业级业务场景,演化为能够理解上下文、调用工具并自主执行复杂任务的生产力引擎。
AI智能体概念的爆发并非仅仅停留在应用层的狂欢,其背后是庞大且明确的算力与基础设施需求支撑。英特尔数据中心集团副总裁、中国区总经理陈葆立援引了一系列震撼的行业数据,勾勒出了Agent时代的增长陡峭曲线。
l 预计到2026年底,全球超过80%的企业应用将至少嵌入一个AI智能体。IDC预测,到2031年,仅中国企业场景中的活跃AI智能体数量就将高达3.5亿个;
l 国内大模型的日均Token调用量正呈现出惊人的爆发力,相较于2024年初,如今的调用规模已暴增5000倍;
l 在底层支撑方面,2026年全球优化型IaaS支出预计将实现96%的同比高速增长。而据美银证券预测,到2029年,中国AI数据中心的固定资产投资规模将突破2.2万亿元人民币。
随着AI智能体的全面渗透,数据中心的工作负载特征正在被彻底改写。业界预测,到2030年,数据中心80%的工作负载都将与AI高度相关。基于此,英特尔提出必须重新审视AI数据中心的系统级架构。
英特尔认为,未来AI数据中心可以大致分为三类核心资源:CPU集群负责Agent任务执行、工作流编排以及通用数据处理;GPU及AI加速器负责高强度模型计算;存储集群则负责模型、上下文、向量数据以及KV Cache等海量数据的保存与调用。
阿里云智能集团资源总监、首席服务器架构师卓久也指出,当前AI数据中心需要从单纯关注GPU,转向对整个系统瓶颈的重新审视。从GPU、CPU到内存、存储,从硬件到软件,都需要进行协同设计。
对于市场上流行的“Agentic CPU”概念,卓久则给出了更加谨慎的判断。现阶段通用CPU在Agent工作流的编排、调度以及复杂控制流处理中本身就具有优势,因此Agent应用增长自然会放大CPU需求。但这并不意味着现有CPU从一开始就是为Agent量身设计的。真正从底层微架构层面针对Agent工作流进行系统性优化的处理器,可能仍处于更早期的产品研发阶段。
英特尔技术专家李尔成也指出,AI应用正在从传统单轮推理走向Agentic多轮工作流,由此改变数据中心内部CPU与GPU的资源配比。部分AI系统中CPU与GPU的比例正在从传统的1:4逐渐向1:1靠近;在一些高度依赖Agent流控和任务编排的场景中,CPU资源需求甚至可能超过GPU。
这种变化并不意味着CPU要替代GPU,而是AI系统中越来越多工作已经超出纯粹的模型计算。在Agentic AI场景下的MoE负载不均衡和KV Cache搬移这两个环境中,CPU可以成为GPU的重要补充。
首先先是在MoE场景中承担“弹性算力池”的角色。当部分热点专家超过GPU负载上限时,与其频繁在不同GPU之间迁移权重,不如将少量溢出的热点专家交给CPU处理。CPU虽然在内存带宽上不及GPU,但拥有更大的内存容量,同时AMX也提供了较强的矩阵计算能力,因此在只承载少量溢出专家时,可以发挥“容量大、算力强”的优势,帮助GPU实现更灵活的异构负载均衡。
另一个重点是KV Cache分层复用。KV Cache虽然能够“以存代算”,但规模越大,对DRAM和SSD容量以及数据搬移效率的要求也越高。针对这一问题,英特尔提出利用至强平台中的DSA和QAT进行优化:DSA负责加速大量小块KV Cache在CPU内存与GPU之间的搬移,同时避免额外占用CPU和GPU计算资源;QAT则负责压缩KV Cache,以降低内存和SSD压力。按照英特尔现场公布的数据,KV Cache压缩幅度可达到20%—30%,同时首Token时延没有明显损失。
其核心思路并不是让CPU替代GPU,而是在GPU最容易出现资源失衡和数据搬移瓶颈的地方,引入CPU及专用加速器承担辅助角色。随着Agent模型规模扩大,CPU、GPU、内存与存储之间的协同,正在成为推理效率优化的重要方向。
二、硬件重器:下一代至强Diamond Rapids(DMR)微架构剖析
在产品路线上,英特尔展现出了极强的节奏感。继2025年推出的主打性能核的至强6及2026年6月发布基于 Intel 18A 制程主打能效核的至强 6+(Clearwater Forest)之后,英特尔针对 Agentic AI 的高并发与内存墙痛点,推出了全新一代至强处理器——代号 Diamond Rapids(DMR),这堪称一款在微架构层面真正瞄准Agentic AI痛点设计的算力核芯。
从目前公布的架构信息来看,Diamond Rapids的重点并不是简单增加核心数量,而是针对高并发、内存带宽、数据移动和系统I/O等问题进行整体升级。
其最高支持256个核心,配备增强版AMX和AVX 10.2指令集,并支持FP8、FP16、BF16等AI常用数据格式。在存储体系方面,其末级缓存最高达到1.28GB,配合16通道内存以及最高12800MT/s的MRDIMM,系统内存带宽最高达到约1.6TB/s。在I/O方面,Diamond Rapids提供128条PCIe 6.0通道,并继续集成QAT、DSA、IAA等专用加速能力。
英特尔技术专家龚海峰从Agent工作流中的系统性能出发,对Diamond Rapids的微架构变化进行了进一步解释。
在智能体工作流中,CPU与GPU高度交织且存在强前后依赖——CPU上的每一毫秒延迟,都会直接转化为GPU的空闲等待时间。评估CPU性能的关键指标,在于“单智能体完成端到端任务的总耗时”与“单位时间内系统可承载的并发智能体数量”。基于这一需求,英特尔提炼出了智能体场景下的CPU性能公式:
在频率与核心数遭遇物理功耗墙的当下,提升性能的唯一突破口在于:提高每时钟周期指令数(IPC),同时极致压缩完成单任务所需的总指令数。为实现这一目标,Diamond Rapids引入了x86架构近年来极具颠覆性的底层革新——APX(Advanced Performance Extensions)指令集。
APX首先将x86通用寄存器从16个扩展到32个。寄存器数量增加后,可以有更多临时数据保留在CPU内部,从而减少数据在寄存器和内存之间反复搬运。
同时,APX还引入NDD(New Data Destination)。传统x86执行类似“A=A+B”的操作时,计算结果会覆盖A。如果后续程序仍需要原始A,就需要额外进行保存。NDD则允许直接执行“C=A+B”,减少一部分额外的数据复制和指令。按照英特尔现场展示的数据,在部分经过APX编译器优化的SPEC CPU 2017代码中,Load/Store指令数量可以减少约40%。
与此同时,Diamond Rapids在芯片封装和内部拓扑上也进行了明显调整。
DMR采用新的Fan-out Fabric架构。整个SoC以两个Fabric Hub Die为中心,负责提供内存和I/O接口,周围分布四个CBB,也就是计算与缓存模块。让不同计算模块能够以相对均衡的路径访问内存和PCIe资源,降低不同芯粒之间访问延迟的差异,同时减少复杂NUMA拓扑给软件调度带来的负担。
Diamond Rapids同时采用3D垂直封装,将大容量SRAM与计算核心进一步靠近。根据英特尔披露的信息,每个相关计算模块下方集成约320MB SRAM,最终整颗处理器的L3缓存最高达到1.28GB。这意味着高端服务器CPU的末级缓存容量开始进入GB级。
对于Agent工作负载而言,更大的缓存可以让更多状态、元数据和热点数据停留在片上,减少CPU频繁访问DRAM。配合UCIe互连、16通道内存以及MRDIMM,Diamond Rapids系统内存带宽最高达到约1.6TB/s。
除了计算和内存,Diamond Rapids也进一步加强了系统I/O能力。在典型八卡GPU服务器中,往往采用双路CPU架构。当GPU进行All-to-All集合通信或跨插槽访问数据时,如果CPU之间以及CPU与GPU之间的互连带宽不足,就可能造成通信拥塞。Diamond Rapids提供128条PCIe 6.0通道,并支持双路平台之间配置多条高速x16互连链路,以提高跨插槽和设备之间的数据传输能力。
英特尔还希望结合处理器内部的遥测能力、余量感知路由和硬件加速器卸载,在满足P99时延和SLA要求的情况下,提高单节点能够稳定承载的Agent数量。
三、软件进化:四大工程重定义底层算力
过去一年里,诸如通义千问办公等各类AI工具如雨后春笋般涌现,用户直观感受到的是“AI越来越好用”,但在这背后,实则是AI软件层面的四次深度演进,这也被陈葆立归纳为四大工程阶段:
Prompt Engineering(提示词工程):人机交互的起点。
Context Engineering(上下文工程):解决大模型“记忆力缺失”的痛点,让原本“没有记忆的天才”能够处理和关联海量背景信息。
Harness Engineering(工具链工程):赋予AI智能体调用外部工具、执行实际任务的“手脚”。
Loop Engineering(闭环工程):这是智能体走向成熟的关键。AI不再只是被动应答,而是像一个严谨的学者,在输出结果后会自主进行重新验算、检查与逻辑自洽,确保最终答案精确契合用户需求。
正是这层层递进的软件创新,直接引发了底层算力结构的质变。从复杂的上下文检索、外部工具的API调度,到多轮逻辑闭环的验算与编排,这些任务极其依赖通用计算能力。这也就是为什么在智能体时代,CPU的重要性不降反升——庞大而繁杂的工作流编排与预处理,需要消耗海量的CPU资源。
除了为Agent提供底层算力,英特尔也在尝试反过来利用AI Agent解决GPU软件生态迁移问题。英特尔技术专家汪洋指出,当前大多数AI开发仍然围绕英伟达CUDA生态展开,而真正困难的并不是API转换本身,而是不同GPU微架构带来的性能差异。传统静态转换工具虽然能够把CUDA代码翻译成其他编程接口,但往往只能解决“能不能运行”的问题,很难保证迁移后的性能。
英特尔的思路,是把代码迁移从简单的语法转换升级为由AI Agent驱动的完整工程流程。其基础是英特尔长期推动的开放软件栈:从vLLM、SGLang等上层推理框架,到PyTorch、Triton、SYCL以及通信和高性能计算库,英特尔希望尽量保持与主流AI生态兼容。与此同时,SYCL基于C++,经过多年发展,已经被大量代码和模型数据覆盖,这也为大模型理解和生成SYCL代码提供了基础。
在实际迁移过程中,AI Agent首先理解CUDA代码背后的算法意图,再重新生成适配英特尔GPU的代码;随后通过性能分析工具读取硬件运行指标,识别性能瓶颈,并结合英特尔提供的微架构优化经验继续自动调优。也就是说,代码生成、编译、验证、性能分析和优化,可以被串成一个自动化闭环。
英特尔公布的一组测试显示,其从开源社区选择了10个项目、共468个算子进行迁移,其中445个完成迁移,完成度约95%;平均单个算子交付成本约0.6美元,耗时约7.9分钟。进一步在Llama.cpp上测试时,AI Agent自动迁移了107个算子,并新增支持17个此前未覆盖的算子。经过后续性能优化后,其中45个算子的性能超过了原有人工编写版本。
这套方法指向的并不只是“把CUDA代码搬到英特尔GPU上”,而是试图降低不同GPU架构之间的软件迁移成本。如果AI Agent能够承担越来越多的代码适配和性能调优工作,那么未来企业选择AI加速器时,软件生态带来的锁定效应可能会有所减弱,硬件之间的竞争也会更多回到性能、成本和整体系统效率本身。
四、云端全栈落地:阿里云与英特尔的软硬协同范式
从实际落地来看,阿里云与英特尔的合作提供了一个较为完整的软硬协同案例。
双方的合作并不是从Agent时代才开始。
早在Sapphire Rapids时期,阿里就在搜索推广场景中尝试CPU与GPU异构计算。尤其是在“双十一”等高峰流量场景下,搜索推广业务中大量Embedding任务运行在CPU侧,而计算更加密集的部分则运行在GPU侧,两类计算资源之间还需要持续进行数据交换。
Sapphire Rapids引入AMX之后,为CPU侧AI计算提供了新的加速能力。因此,在Sapphire Rapids推出早期,阿里就将其部署到“双十一”主搜索推理场景,并围绕算子和模型进行了大量迁移和调整。英特尔工程团队也参与了相关优化。这次合作验证了AMX在大规模线上业务中的可用性,也成为双方后续继续深化软硬协同的重要基础。
进入Agentic AI阶段之后,合作范围进一步扩大到云服务器、块存储、数据库、AI推理以及端侧计算等多个层面。
目前,阿里云基于英特尔平台的九代实例已经形成千万核规模,并成为承载Agent应用的重要基础设施之一。九代实例采用英特尔至强6处理器,并根据不同Agent负载进行产品化设计。例如,重负载Agent、高并发浏览器Agent、RAG、大内存应用以及工具调用,对算力、内存、I/O和启动速度的需求都存在差异,因此阿里基于同一平台衍生出了多种实例形态。
阿里并没有只使用至强6的通用CPU性能,而是进一步利用AMX、QAT、IAA、DSA等专用加速能力。其中,AMX用于FP16计算、向量检索和Embedding等任务;QAT用于数据压缩;IAA则可以用于快照压缩和解压缩,从而缩短沙箱启动时间。
这些实践体现出Agent负载的一个重要特点:峰值突发性较强,同时任务链长、资源需求不确定,因此底层基础设施不仅要追求峰值性能,还需要同时考虑弹性和成本。
双方在存储领域的合作进一步体现了这种软硬协同。
阿里云磐久九代存储服务器围绕英特尔至强6进行了多项微架构级优化。在数据链路上,阿里利用DDIO让PCIe设备的数据直接进入末级缓存,减少DRAM访问;利用DSA卸载数据搬移和CRC校验,让CPU更多用于任务调度;同时通过CPU指令集优化纠删编码等计算任务。经过这些优化,阿里披露其单线程能力提升超过40%。
在压缩环节,双方进一步引入QAT。传统软件压缩不仅消耗大量CPU资源,还需要进行CRC校验、解压验证等步骤。通过软硬件联合优化,其中部分工作可以交给硬件加速器完成。阿里公布的测试结果显示,压缩带宽提升约400%,参与压缩任务的CPU核心数量降低75%。如果把上一代平台整体性能定义为1,仅通过新一代硬件升级,吞吐可以提升到约1.5倍;进一步加入软硬协同优化后,整体吞吐可以达到约4倍。目前,这些优化已经在阿里云存储生产环境中大规模部署。
除了云服务器和存储,双方也开始围绕Agent执行环境进行优化。
大量Agent任务需要调用浏览器完成网页访问、表单操作以及跨站业务流程,但传统Chromium浏览器主要围绕人类交互设计,其中包含大量桌面UI和交互模块,在大规模Agent并发场景下会带来较高的内存和资源开销。
为此,阿里云与英特尔围绕Agentic Browser进行了轻量化优化。其基本思路是保留Blink渲染引擎和V8 JavaScript引擎,减少与桌面UI和人工交互相关的模块,再将裁剪后的浏览器能力以预编译SDK方式部署到阿里云弹性算力基础设施。在硬件侧,则结合AVX-512、IAA和QAT等能力,加速脚本执行、数据处理和内存压缩。
根据现场披露的数据,优化后单个Agent实例的常驻内存开销降低约30%,从而提高同一资源池中可同时运行的浏览器实例数量。
Agentic Browser还引入了“双环”机制。首次执行时,由主Agent负责完成推理、规划和流程探索;流程一旦成功,可以进一步沉淀为可复用的RPA自动化工作流。后续执行相同任务时,可以直接重放脚本,只有出现异常情况时才重新调用主Agent进行规划。
按照现场测试数据,这种方式在部分重复性任务中可以显著减少模型推理次数和Token消耗。相较于每一步都重新调用大模型,“AI负责规划、自动化系统负责重复执行”的模式,更适合企业级Agent对于稳定性和成本的要求。
双方合作还在从CPU向GPU以及更大规模的AI系统延伸。
阿里方面提到,在导入包括英特尔GPU在内的新加速器时,评估标准已经不再局限于单颗芯片的理论性能,而是进一步覆盖Profiler、质量检测、故障诊断、微架构分析和性能评测等完整软件工具链。
甚至在硬件实物到位之前,就可以基于GPU微架构开展Cycle级仿真,通过寄存器、共享内存、L2、HBM等多级存储结构,对任务切分、执行顺序以及计算与访存之间的竞争进行分析,从而提前缩小优化空间。
在更长期的系统架构上,阿里也在推进AL144、AL64等超节点,并计划进一步与英特尔CPU平台进行联合调优。
面对更大规模的MoE模型以及更加严格的推理SLA,仅依赖传统单机或者PCIe扩展已经难以满足全部需求。
未来甚至可能根据Attention和FFN不同阶段对于算力、内存和带宽的不同需求,选择不同类型的处理器构建异构超节点。
从这些合作可以看到,阿里与英特尔之间的关系已经不再是简单的CPU采购。过去云厂商选择CPU,核心关注的是核心数量、频率、内存带宽以及单位成本;而到了AI时代,仅靠单颗芯片已经越来越难决定最终系统性能。模型、编译器、算子、存储、网络、服务器架构以及真实业务负载,都需要围绕硬件进行协同优化。
结语
AI Agent 元年的到来,宣告了数据中心单纯堆叠 GPU 峰值算力时代的结束。未来的算力版图不再是单一生态的独角戏,而是一场涵盖 CPU 调度编排、GPU 密集计算、智能体代码重构以及云端场景微创新的全栈协同演进。我们也期待英特尔Diamond Rapid所带来的更多可能性。
责任编辑:duqin
相关文章
-
- 半导体行业观察
-
- 摩尔芯闻
最新新闻
热门文章 本日 七天 本月
热门评论
©2025 半导体行业观察
Copyright©2023 芯算智能科技(扬州)有限公司
苏ICP备2025200240号-2 皖公网安备 34019202000656号