以CPU为核心,英特尔为智能体AI打造全新智算中心
2026-09-23
14:36:53
来源: 李晨光
点击
9月22日,2026英特尔技术创新与产业生态大会在苏州国际博览中心开幕。本届大会以“同芯·智远”为主题,聚焦智能体AI(Agentic AI)从技术探索走向产业实践的行业趋势。
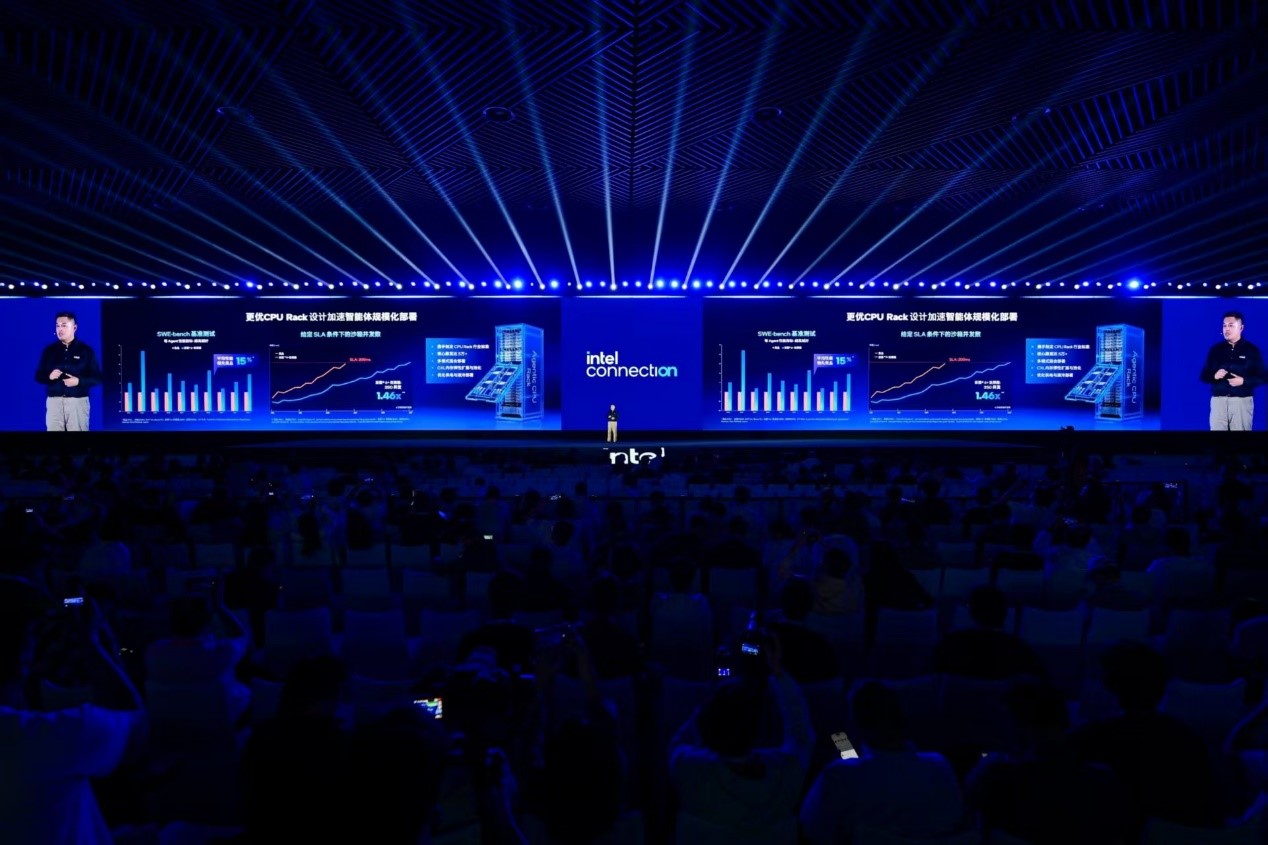
在数据中心专场,英特尔数据中心集团副总裁、中国区总经理陈葆立(Peter Chen)携软件工程及技术团队,系统阐释了智能体时代下数据中心架构的演进逻辑,发布了覆盖CPU、存储、加速引擎的全栈算力解决方案,并围绕CPU价值回归、KV Cache瓶颈破解、沙箱高密度部署、智算中心选型等核心行业议题,详解了英特尔的技术布局与落地实践。
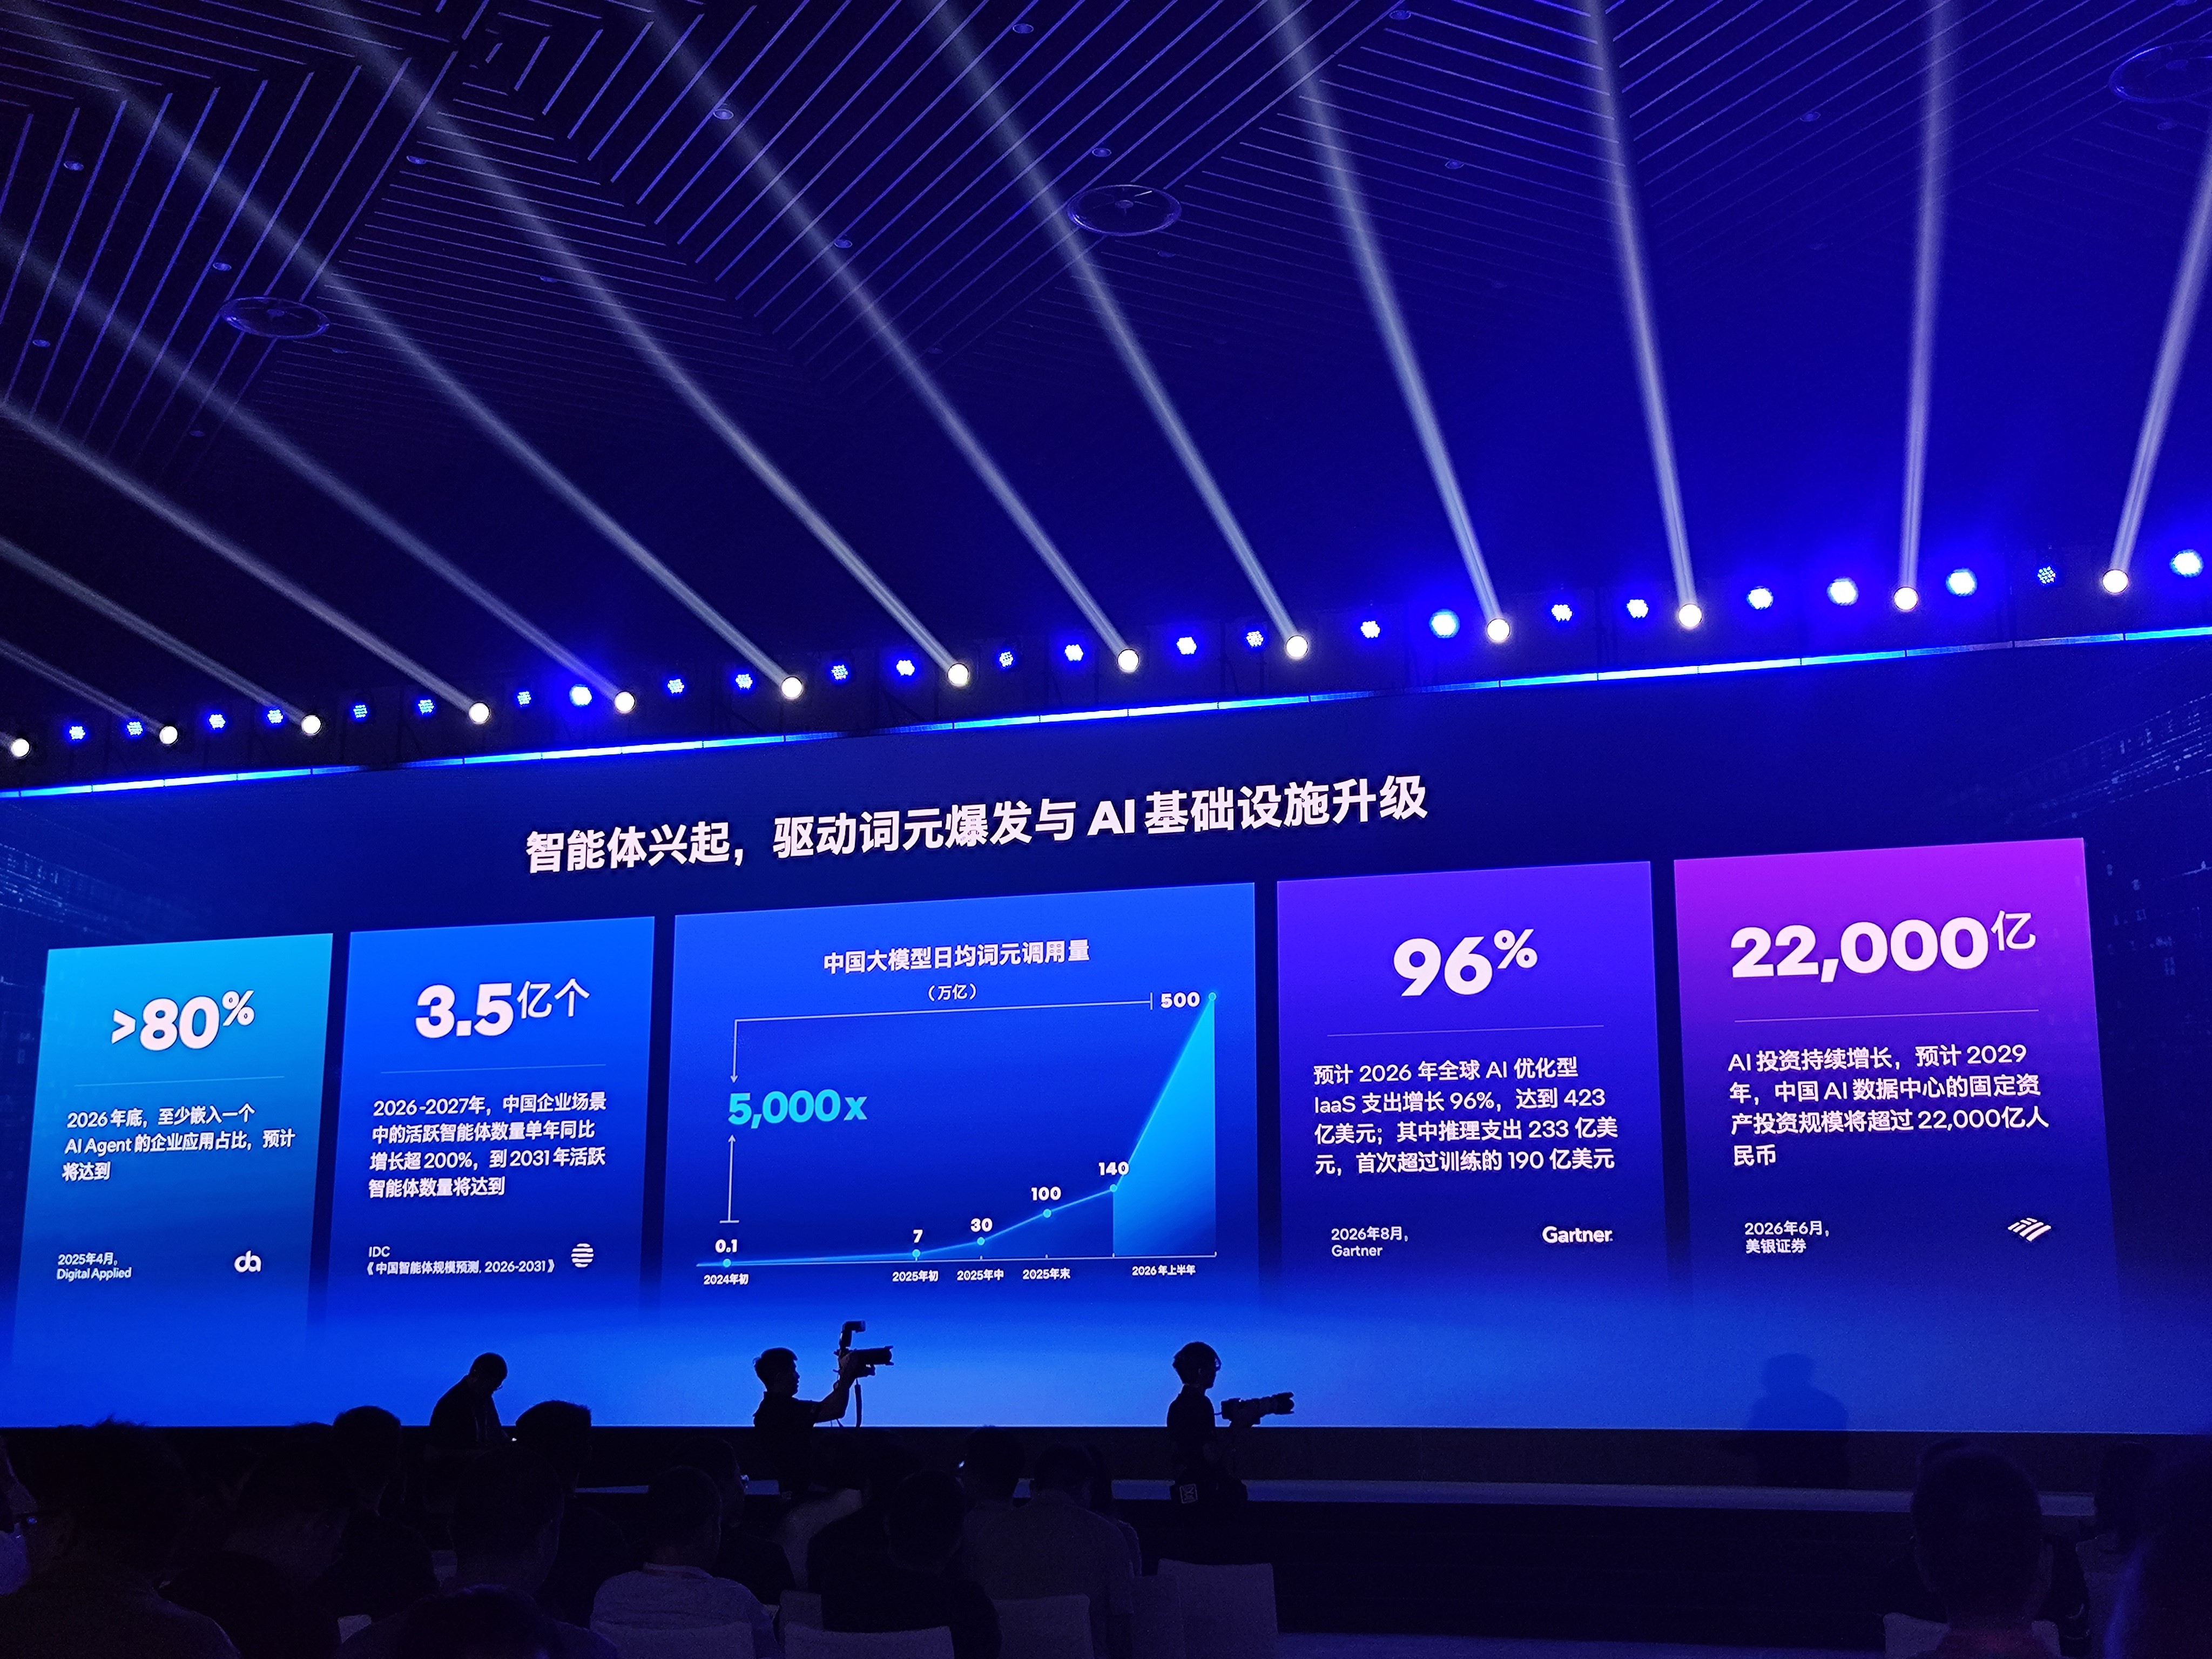
在主题演讲中,陈葆立分享了一组引人注目的数字:预计到2026年底,超过80%的企业应用将至少嵌入一个AI智能体;到2031年,中国企业场景中的活跃智能体数量将达到3.5亿个;中国大模型每天的Token调用量已增至2024年初的5000倍。
与此同时,CPU市场规模预估在短短半年内从590亿美元上调至2100亿美元,约为原来预测值的3.6倍。这些数字背后,折射出一个根本性的判断:AI的下半场是推理与智能体,CPU正在重新回到智算中心的核心中枢位置。
CPU重回C位:从“机头”到“中枢”
“AI智能体从思考到执行,牵动的是模型推理、任务编排、数据搬运与记忆管理的完整链路。因此,全新的智算中心,应该以CPU为核心、CPU与GPU、IPU、存储协同运作,而不是单纯比拼某一环节的参数。”陈葆立阐述英特尔对智算中心架构的判断。
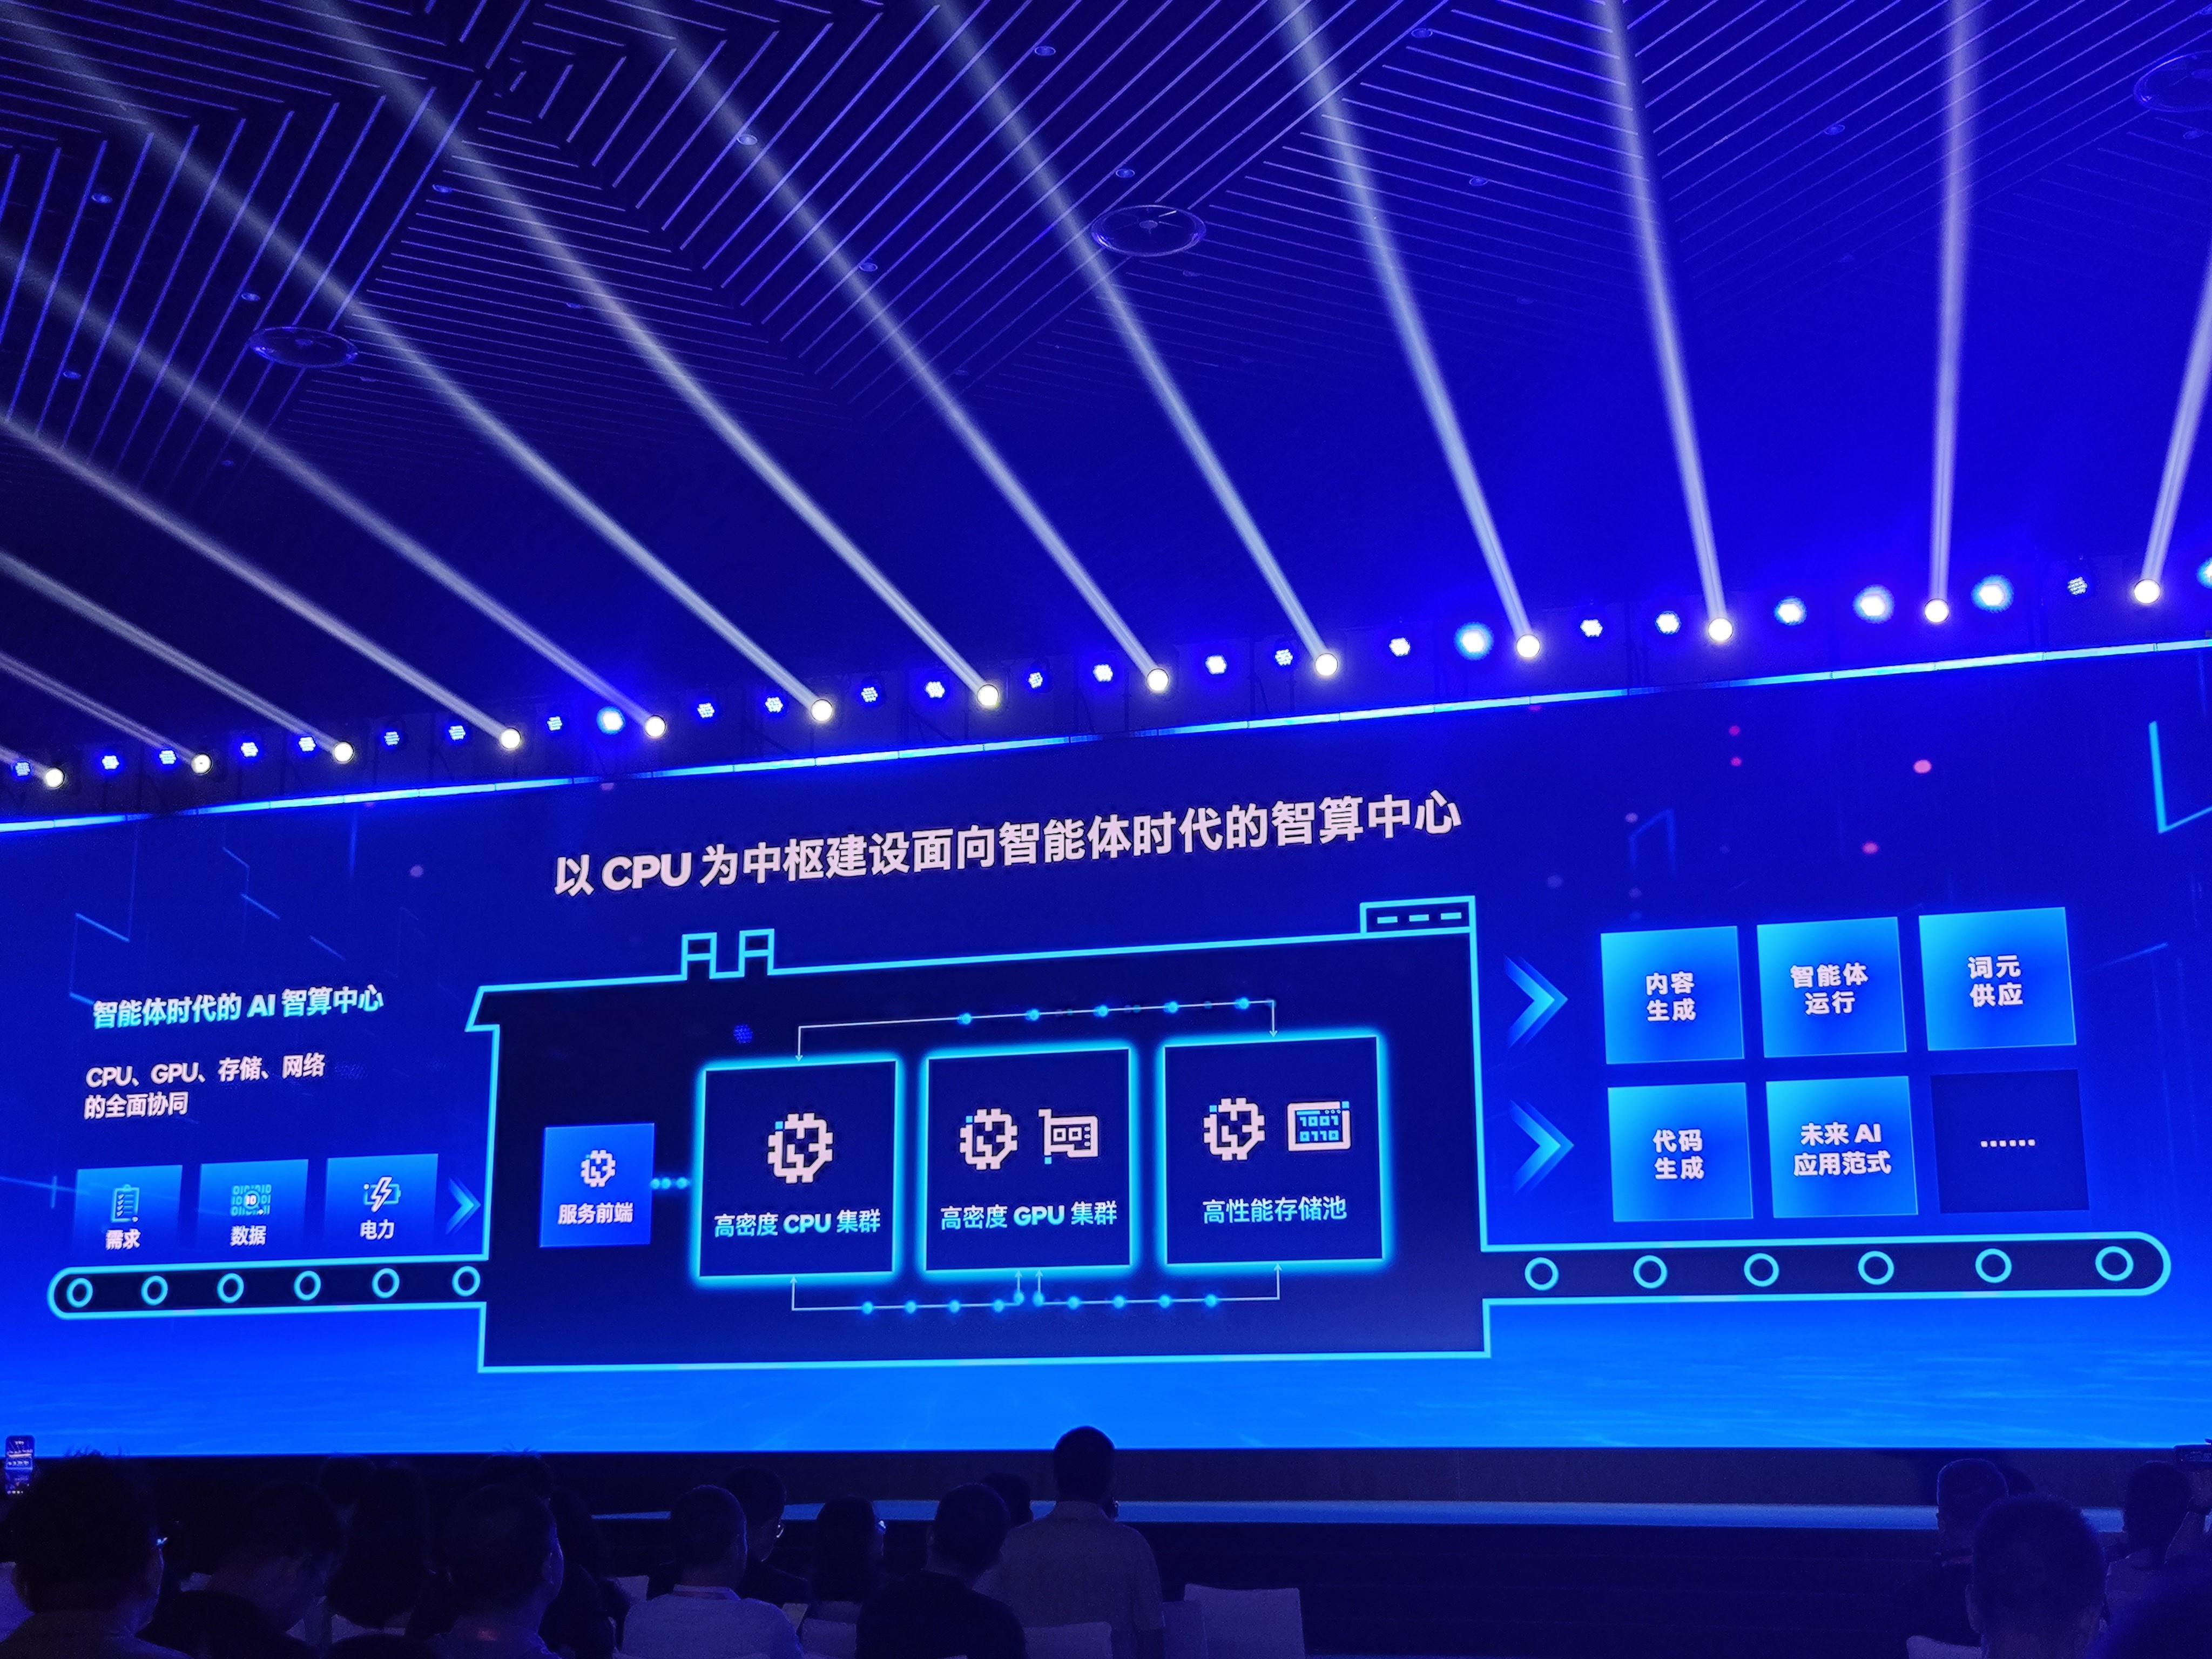
这一判断建立在智能体工作流的实际需求之上。在Agentic AI时代,智能体的流程编排与指令控制,包括工作流规划、多Agent协同、上下文管理及依赖处理,全部运行在CPU上;信息检索与工具调用,如网页搜索、数据库查询、API接口调用及数据解析,同样依赖CPU;在机头侧,CPU还需实时为GPU输送清洗后的数据,若CPU性能不足,昂贵的GPU将面临算力饥饿。
正如陈葆立所比喻的:过去大模型是“思想上的巨人,行动上的矮子”,而智能体时代,AI真正开始执行了,执行过程一定放在CPU上。
至强6+:为智能体而生的算力底座
今年6月,英特尔发布了全新英特尔至强6+处理器,采用Intel 18A制程,拥有业界领先的288个能效核(E-core),单液冷机架(32U)即可提供36864个核心。同期推出的智能体套件,能够在单颗288核至强处理器上部署近1000个智能体。
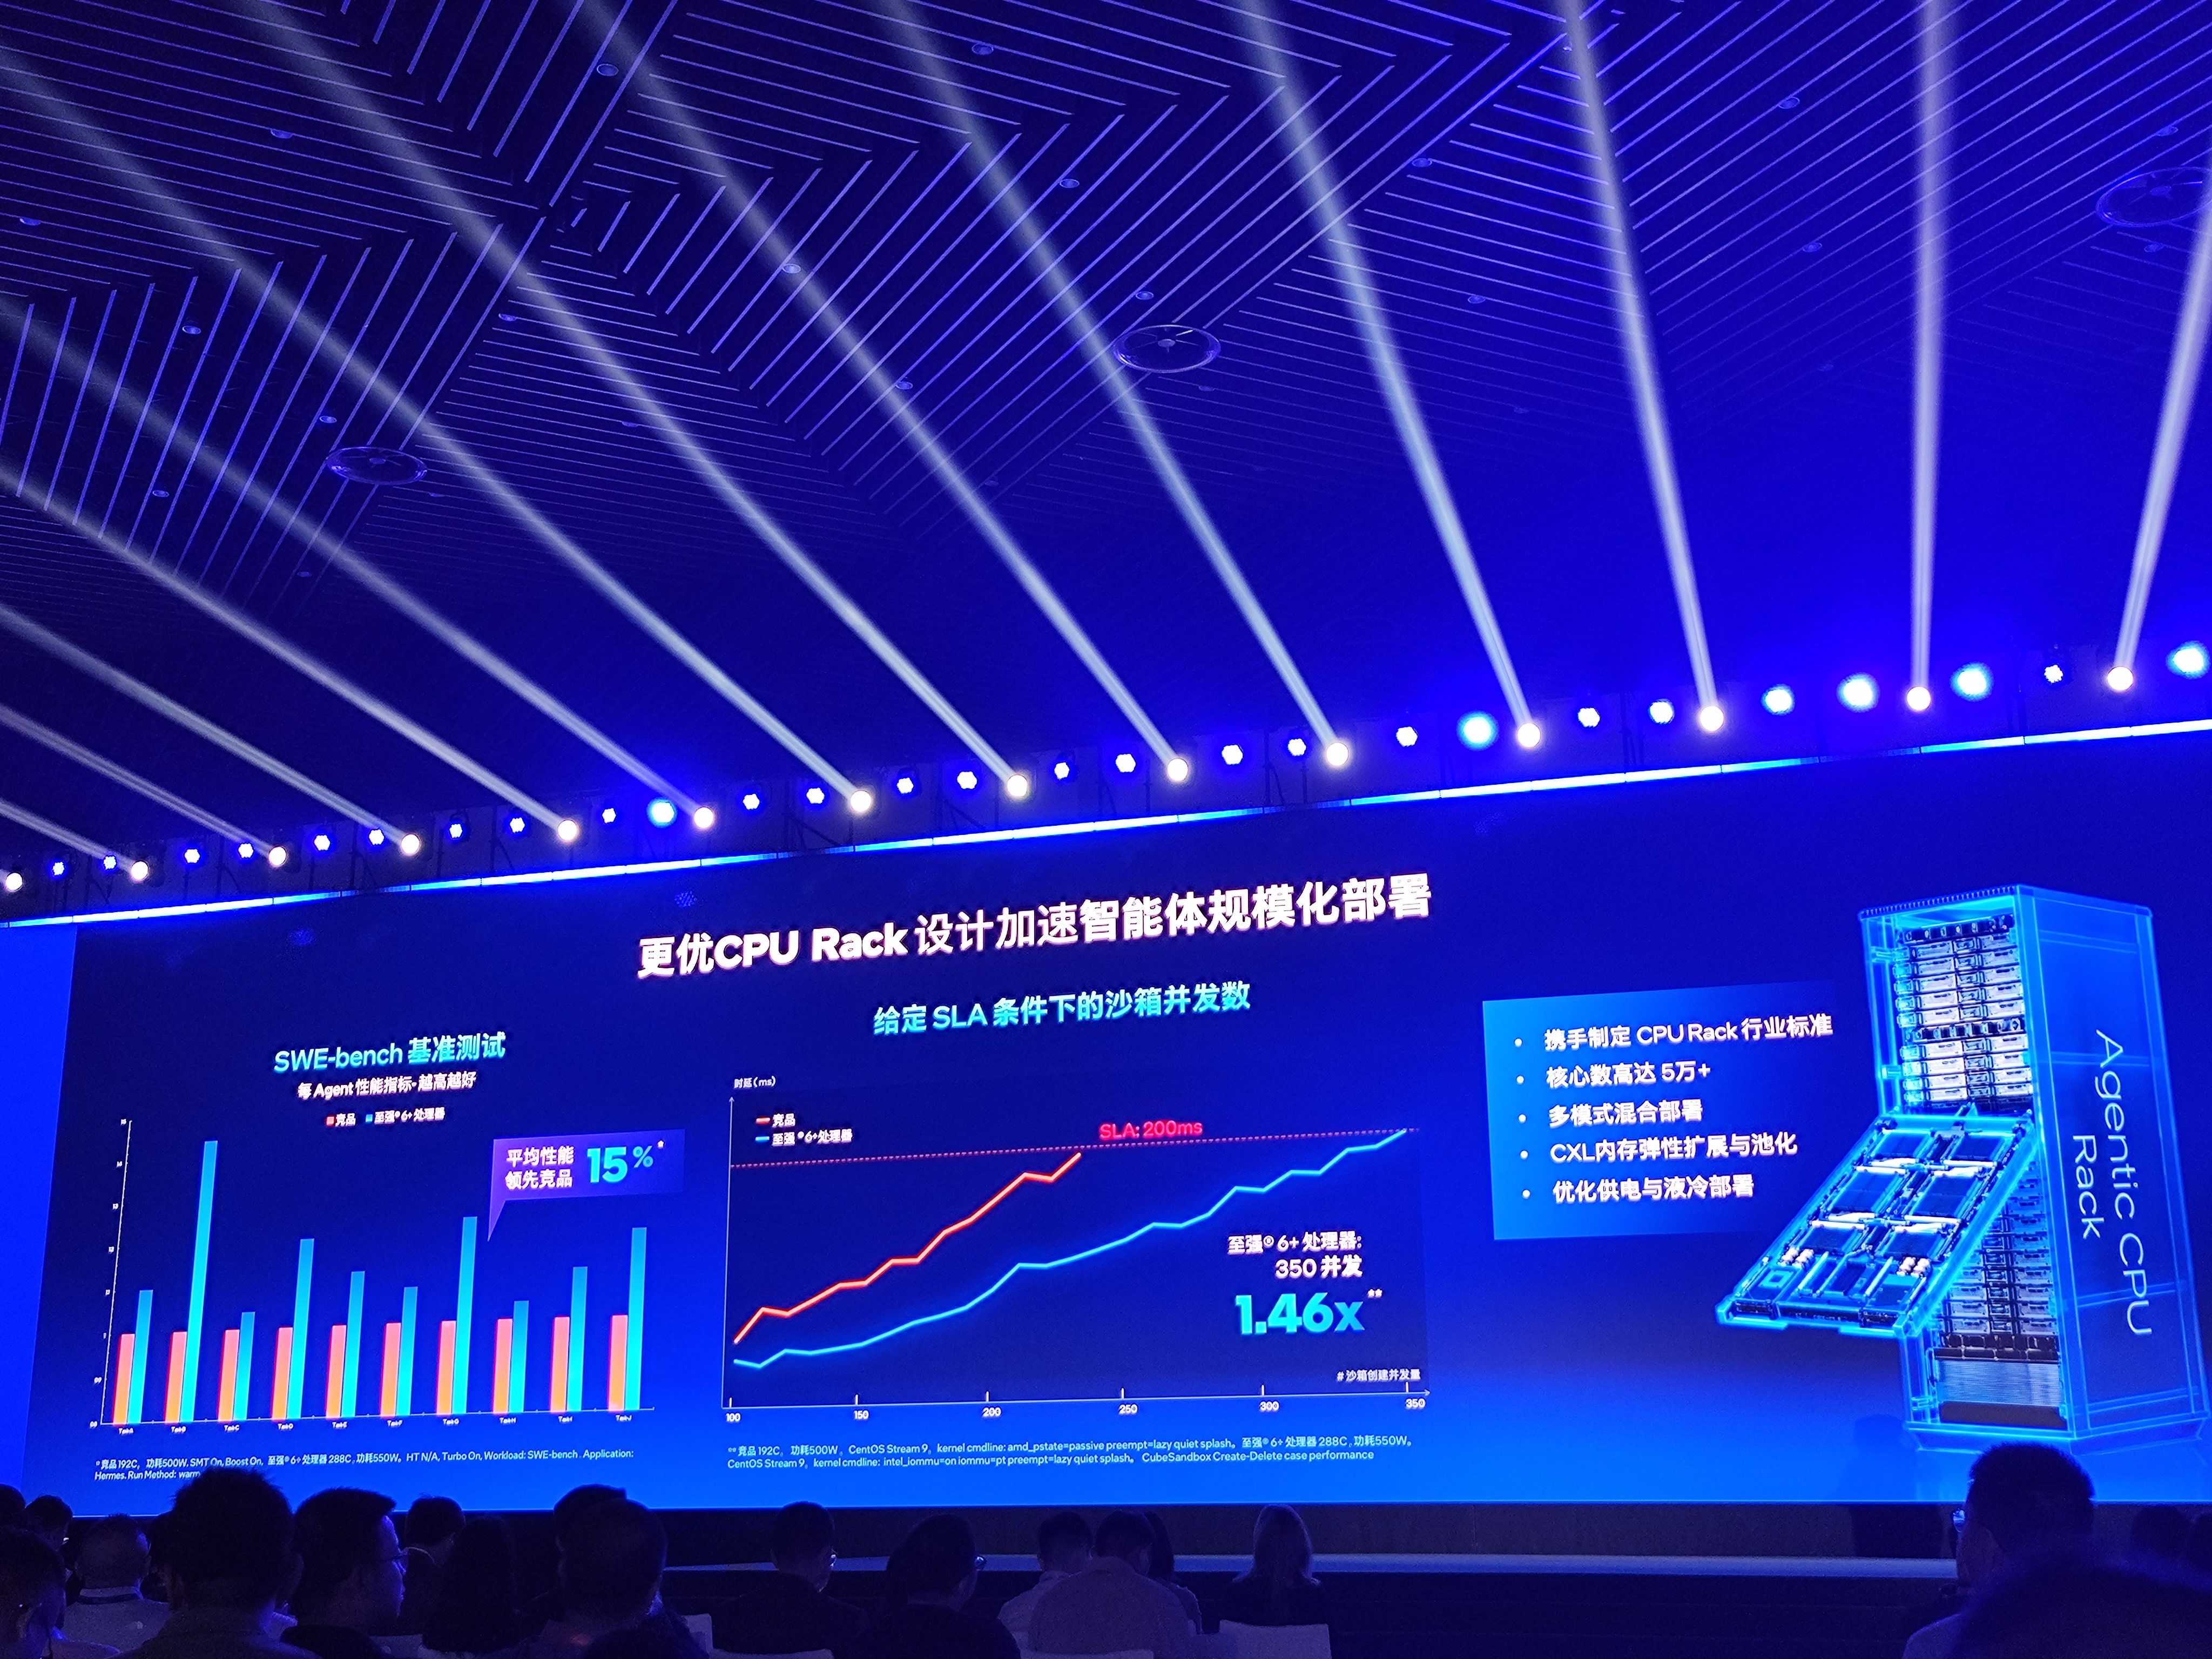
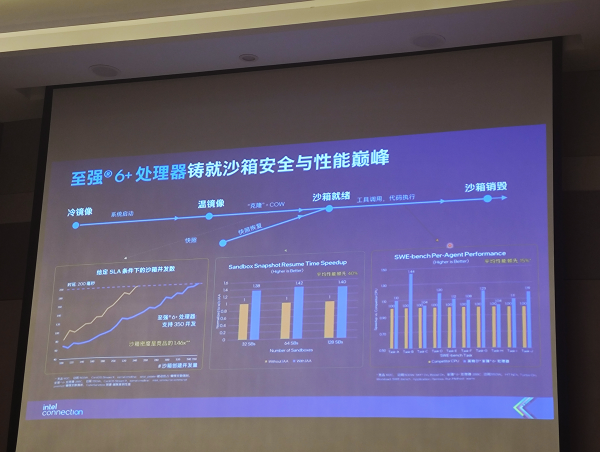
陈葆立分享了与国内客户实测的数据:在SWE-bench基准测试中,至强6+的单智能体平均性能领先竞品15%。在客户提出的“10分钟内启动1万个甚至10万个沙箱”需求下,满足200毫秒SLA约束条件时,至强6+可支持350个沙箱并发,约为某竞品的1.46倍。“使用至强6+运行智能体,不仅性能好,而且速度更快。”陈葆立表示。
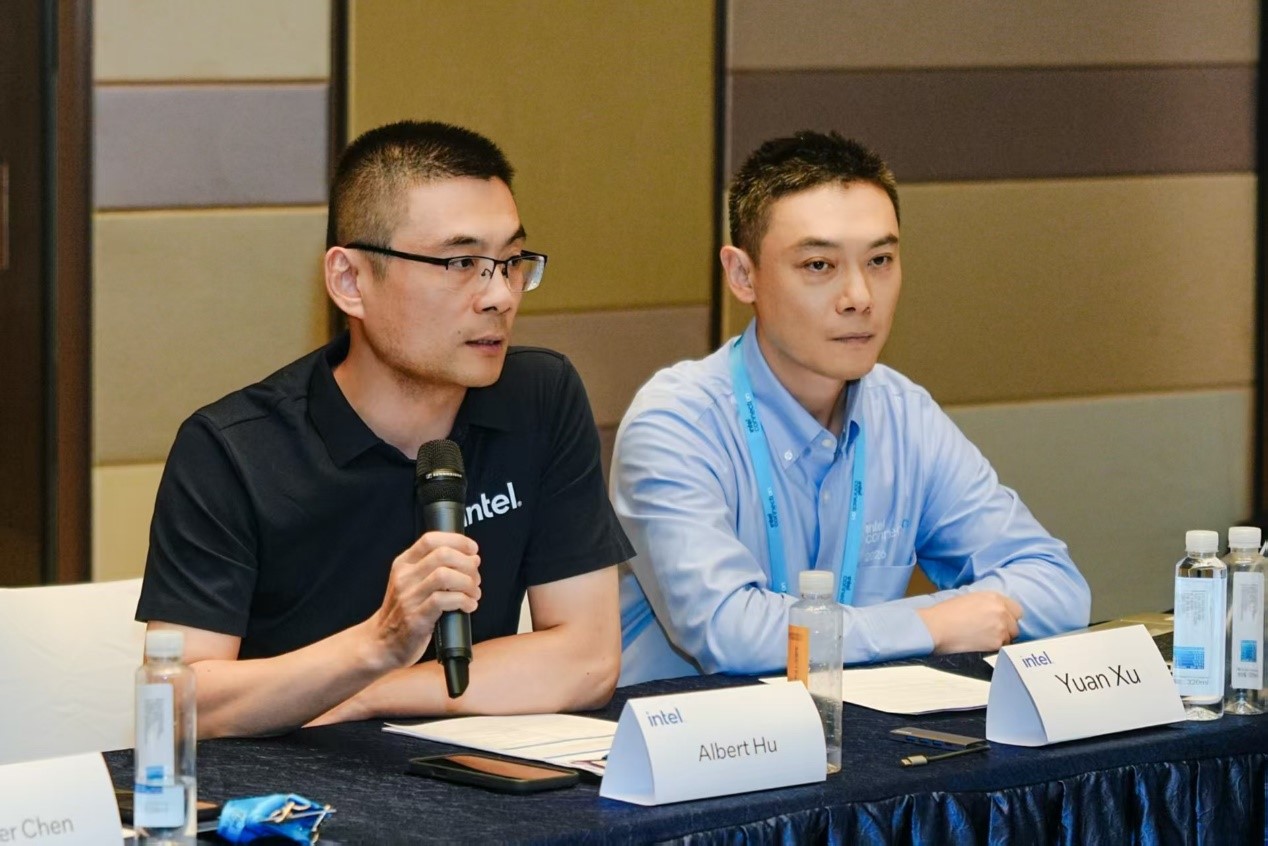
英特尔数据中心集团软件工程经理胡勇在媒体群访中进一步解释了至强6+适配Agent沙箱需求的设计逻辑:第一,系统重载下不跳频,两百多个核心同时工作时频率不下降,性能几乎线性交付,保证输出性能的同时提升整体密度;第二,沙箱需要及时拉起执行任务、用完即销毁,对高并发、低延时提出要求;第三,支持超配,一个CPU核心可同时部署4个甚至更多Agent,分时复用系统资源;第四,从四代至强开始集成的IAA、QAT、DSA等硬件加速器,对内存数据的压缩/解压缩、加密/解密或搬运不占用CPU或GPU资源,在Agent场景中帮助数据搬运。
KV Cache难题与KVShrink方案
随着智能体AI的发展,长上下文与多轮对话导致KV Cache呈爆炸式增长。
英特尔在接受媒体采访时形象地比喻:Agent在推理、统筹、做规划和对话过程中,需要把工作记忆留存在“草稿纸”上,这就是KV Cache。问题越来越复杂,上下文越来越长,“草稿纸”的数量爆炸式增长,成千上万的Agent协同工作时,它们没有花更多时间在思考上,而是花在存储、查找、规划、管理“草稿纸”上。
陈葆立在演讲中给出了一组直观数据:以标准的千问35B模型为例,如果给它100万Token上下文,产生的KV Cache就是300GB,已超过不少GPU的内置HBM容量。KV Cache命中率在Agent场景下可达50%-70%,但HBM显存昂贵且容量有限,传统缓存驱逐机制又会导致后续提问时被迫重新计算历史Token,TTFT(首Token时延)暴增,严重破坏用户体验。
对此,英特尔推出了KVShrink分层卸载与硬件压缩加速方案,核心思路是“以存代算、分层卸载、硬件压缩”。系统将KV Cache按访问热度分层流动:极热数据常驻L1层(GPU HBM显存),保障低延迟响应;热数据卸载至L2层(DDR内存),通过大容量缓存池扩容降本;温冷数据下沉至L3/L4层(本地SSD或远端分布式存储),实现持久化复用。CPU是驱动KVShrink机制运转的核心,承担着KV Cache压缩、调度、分层存储与生命周期管理的重要职责,其内置的英特尔QAT是KVShrink运转的重要基础。
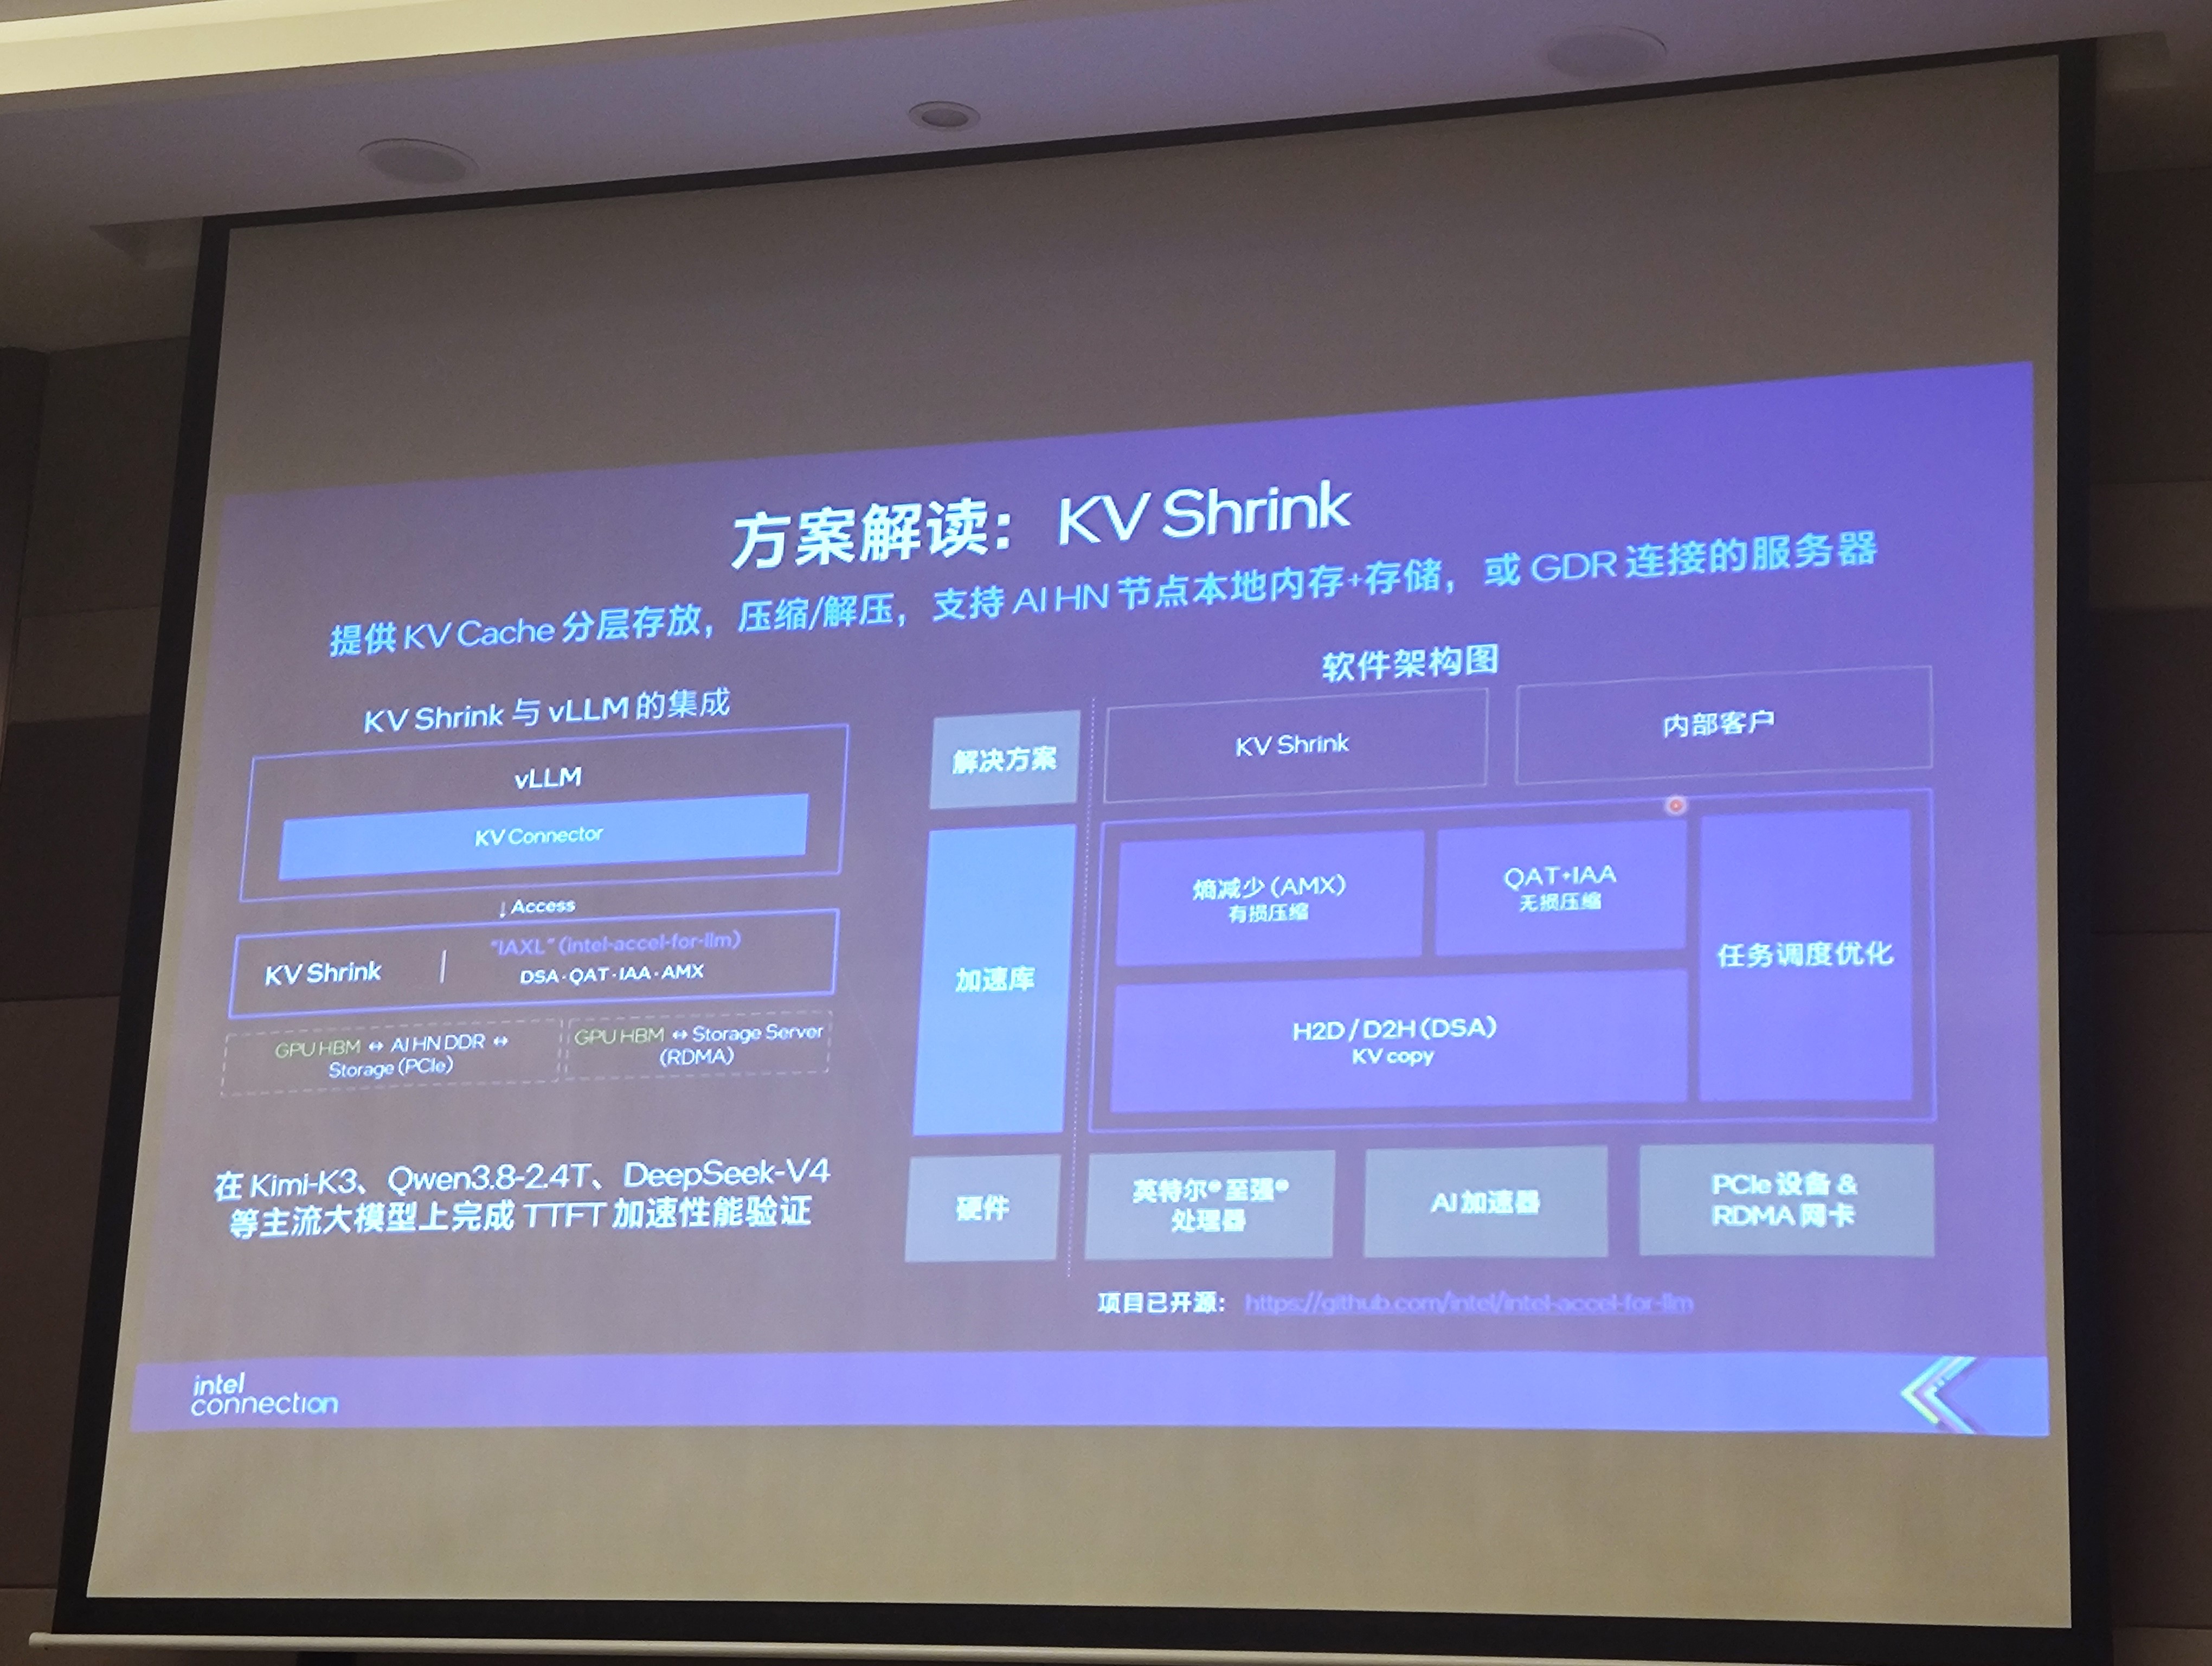
针对不同服务器架构与GPU选型,英特尔提供了灵活的QAT加速方案:机头CPU为至强时,至强作为控制中枢,利用内置QAT引擎对卸载到Host DDR内存(L2)或本地SSD(L3)的KV Cache进行无损压缩与解压调度;在机头CPU并非至强或机头资源不足时,通过GDS/GPU Direct Storage和RDMA将KV Cache卸载到外部扩展节点或高性能存储形态的服务器,GPU通过GDS或GDR加GDS直接访问远端节点,该节点可采用JBOF等产品形态,并使用至强CPU执行KV Cache压缩及其他处理。
据介绍,通过QAT进行无损压缩,原本300GB的KV Cache可以在落盘之前压缩至200GB;通过DSA可实现数据搬运9.66倍的加速效果。客户验证数据显示,英特尔KV Cache智能加速套件能够将KV Cache传输速率最高提升达9.66倍,首字时延(TTFT)性能最高提升达15倍。
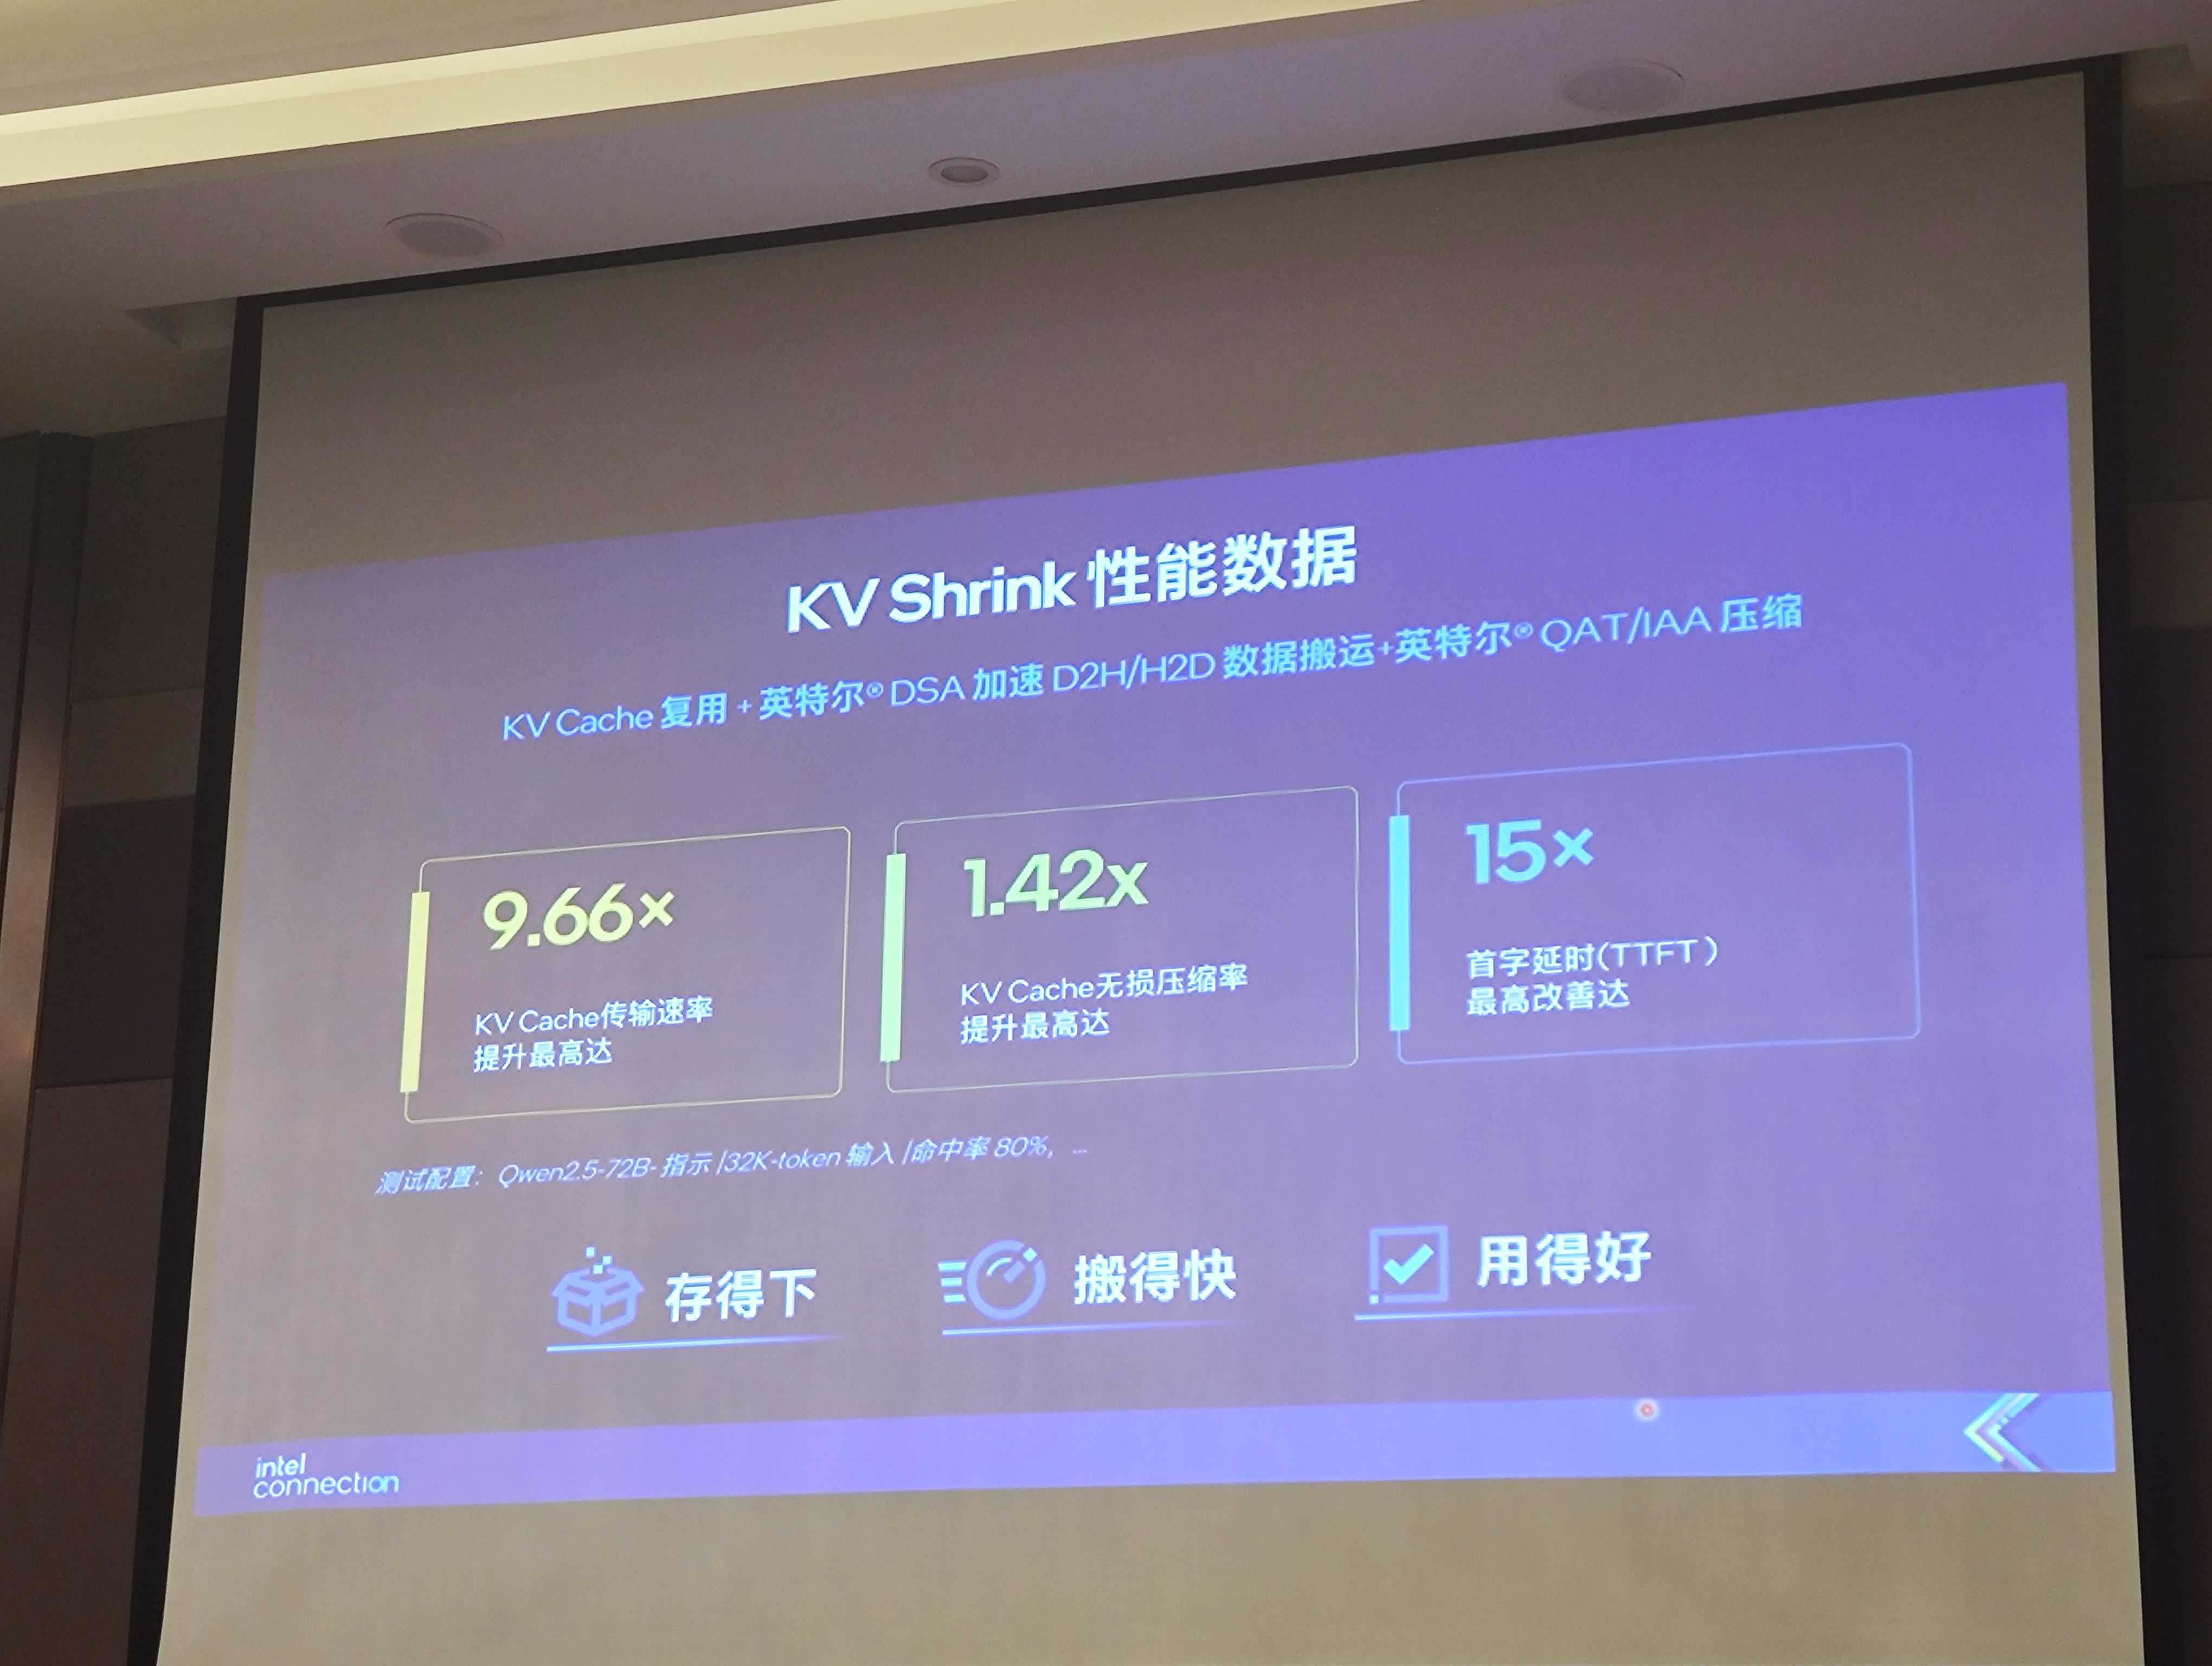
英特尔KV Cache智能加速套件已在GitHub上开源,涵盖KV Shrink、KV Infinity、KV Cascade、KV Fuse等方案,从扩展、压缩、聚焦到复用,形成KV Cache全生命周期优化,突破HBM容量边界并提升推理效率。
胡勇在受访中解释了一个看似矛盾的问题——为什么压缩和解压缩多了一道工作,速度反而提升?“我们做了一些设计,把任务的调度和编排,让每一层的KV Cache在处理这一层的时候就知道下一层要用,提前把它prefetch过来,把延迟隐藏在重叠的流水线当中。”他说道。
Sandbox:Agent时代的“必选项”
当AI Agent被纳入更多生产环境,作为Agent关键执行环境的沙箱(Sandbox)迅速从可选变成必选。据介绍,沙箱是一个轻量化的虚拟机(Micro-VM),无论是操作系统镜像还是文件系统都做了定制化裁剪,主要目的是在满足基本功能的情况下更快、更轻、占用更少内存、启动更快。沙箱存在的必要性在于两方面:保护自己——Agent处理敏感内容信息时不希望被系统中其他软件看到;保护他人——Agent执行的内容很多是大语言模型自己产生的,包括生成的代码、对文件系统的操作甚至访问外部系统,无法预料是否会出现问题。
业内衡量一套沙箱体系通常看三个指标:快(启动速度)、多(密度,一台服务器能同时承载多少沙箱直接决定成本)、独立(隔离到位,每个工作间互相独立)。英特尔的差异化优势在于IAA硬件加速与内存超卖。IAA(内存分析加速器)专门用于快照无损压缩数据的硬件级解压,其优势包括:CPU占用极低,解压过程几乎不占用CPU主频(CPU利用率接近0%);恢复速度相比不压缩方案,沙箱拉起/加载速度提升30%-50%;快照创建性能比未压缩方案提升接近2倍。
英特尔还强调了至强6+在沙箱场景中的系统级优势:至强6+在系统重载情况下不跳频,两百多个核心同时工作频率不下降,性能几乎线性交付;支持超配,一个CPU核心可同时部署4个甚至更高数量的Agent,分时复用系统资源;RAS特性和TDX加密隔离在Agent时代越来越重要,因为越来越多的任务执行时互相之间可能会有冲突,强隔离非常重要。
存储与网络:系统级协同
在存储层面,英特尔携手国内焱融科技,基于英特尔至强6处理器和MRDIMM内存打造了高性能全闪存储系统。焱融科技参与MLPerf Storage v3.0测试,在Llama3检查点读写和3D-Unet训练两项测试中取得全球第一的成绩。陈葆立表示:“我们打造这套高性能存储系统,最重要的是能够让存储跑得更快,避免数据访问成为瓶颈,让昂贵的CPU、GPU不必空等。”
在网络与GPU方面,英特尔发布了新一代GPU Crescent Island,基于全新Xe3P架构,面向AI推理和Agentic AI场景设计,通过LPDDR5x技术可配备128G、256G甚至480G大容量内存,帮助更好地进行AI推理和KV Cache存储。软件层面,英特尔在PyTorch、vLLM、SGLang等开源项目中持续投入,希望包括Agentic AI在内的新功能能够在社区项目中得到体现,更好地适配不同硬件。
据透露,英特尔正在与包括OEM和液冷厂商在内的国内众多硬件合作伙伴,共同制定面向AI智能体的CPU机架方案标准。根据目前可预见的AI智能体性能需求,综合考虑CPU性能、网络、存储、散热以及供电,打造一套平衡的、全新的面向AI智能体的CPU机架方案,核心数可达5万以上,支持多模式混合部署、CXL内存弹性扩展与池化,并优化供电与液冷部署。英特尔将很快与国内合作伙伴一起将其推向市场。
结语
在演讲结尾,陈葆立回归大会主题“开放、合作、创新”:“智能体时代才刚刚开始,未来肯定会有很多新的创新、新的挑战。有一句老话说得好——独行快、众行远。未来的AI发展道路上有很多机会、很多挑战,我们也希望继续与产业界伙伴携手创新,拥抱未来的新世界。”
从至强6+的288核高密度算力,到KVShrink的全生命周期KV Cache优化,再到Sandbox的IAA硬件加速与CPU Rack行业标准制定,英特尔正在以CPU为中枢,构建一套覆盖云、边、端的完整智算中心方案。
正如陈葆立所言:“在英特尔那么多年,我们一直在重复做一件事,就是解决客户的问题。客户的问题每年可能不一样,但在问题出现的时候,如果能够通过我们技术的积累和技术的手段,帮助他们更快地完成他们想要做的事情,我觉得这就是帮助到客户成功,帮助到我们自己成功。”
在数据中心专场,英特尔数据中心集团副总裁、中国区总经理陈葆立(Peter Chen)携软件工程及技术团队,系统阐释了智能体时代下数据中心架构的演进逻辑,发布了覆盖CPU、存储、加速引擎的全栈算力解决方案,并围绕CPU价值回归、KV Cache瓶颈破解、沙箱高密度部署、智算中心选型等核心行业议题,详解了英特尔的技术布局与落地实践。
在主题演讲中,陈葆立分享了一组引人注目的数字:预计到2026年底,超过80%的企业应用将至少嵌入一个AI智能体;到2031年,中国企业场景中的活跃智能体数量将达到3.5亿个;中国大模型每天的Token调用量已增至2024年初的5000倍。
与此同时,CPU市场规模预估在短短半年内从590亿美元上调至2100亿美元,约为原来预测值的3.6倍。这些数字背后,折射出一个根本性的判断:AI的下半场是推理与智能体,CPU正在重新回到智算中心的核心中枢位置。
CPU重回C位:从“机头”到“中枢”
“AI智能体从思考到执行,牵动的是模型推理、任务编排、数据搬运与记忆管理的完整链路。因此,全新的智算中心,应该以CPU为核心、CPU与GPU、IPU、存储协同运作,而不是单纯比拼某一环节的参数。”陈葆立阐述英特尔对智算中心架构的判断。
这一判断建立在智能体工作流的实际需求之上。在Agentic AI时代,智能体的流程编排与指令控制,包括工作流规划、多Agent协同、上下文管理及依赖处理,全部运行在CPU上;信息检索与工具调用,如网页搜索、数据库查询、API接口调用及数据解析,同样依赖CPU;在机头侧,CPU还需实时为GPU输送清洗后的数据,若CPU性能不足,昂贵的GPU将面临算力饥饿。
正如陈葆立所比喻的:过去大模型是“思想上的巨人,行动上的矮子”,而智能体时代,AI真正开始执行了,执行过程一定放在CPU上。
至强6+:为智能体而生的算力底座
今年6月,英特尔发布了全新英特尔至强6+处理器,采用Intel 18A制程,拥有业界领先的288个能效核(E-core),单液冷机架(32U)即可提供36864个核心。同期推出的智能体套件,能够在单颗288核至强处理器上部署近1000个智能体。
陈葆立分享了与国内客户实测的数据:在SWE-bench基准测试中,至强6+的单智能体平均性能领先竞品15%。在客户提出的“10分钟内启动1万个甚至10万个沙箱”需求下,满足200毫秒SLA约束条件时,至强6+可支持350个沙箱并发,约为某竞品的1.46倍。“使用至强6+运行智能体,不仅性能好,而且速度更快。”陈葆立表示。
英特尔数据中心集团软件工程经理胡勇在媒体群访中进一步解释了至强6+适配Agent沙箱需求的设计逻辑:第一,系统重载下不跳频,两百多个核心同时工作时频率不下降,性能几乎线性交付,保证输出性能的同时提升整体密度;第二,沙箱需要及时拉起执行任务、用完即销毁,对高并发、低延时提出要求;第三,支持超配,一个CPU核心可同时部署4个甚至更多Agent,分时复用系统资源;第四,从四代至强开始集成的IAA、QAT、DSA等硬件加速器,对内存数据的压缩/解压缩、加密/解密或搬运不占用CPU或GPU资源,在Agent场景中帮助数据搬运。
KV Cache难题与KVShrink方案
随着智能体AI的发展,长上下文与多轮对话导致KV Cache呈爆炸式增长。
英特尔在接受媒体采访时形象地比喻:Agent在推理、统筹、做规划和对话过程中,需要把工作记忆留存在“草稿纸”上,这就是KV Cache。问题越来越复杂,上下文越来越长,“草稿纸”的数量爆炸式增长,成千上万的Agent协同工作时,它们没有花更多时间在思考上,而是花在存储、查找、规划、管理“草稿纸”上。
陈葆立在演讲中给出了一组直观数据:以标准的千问35B模型为例,如果给它100万Token上下文,产生的KV Cache就是300GB,已超过不少GPU的内置HBM容量。KV Cache命中率在Agent场景下可达50%-70%,但HBM显存昂贵且容量有限,传统缓存驱逐机制又会导致后续提问时被迫重新计算历史Token,TTFT(首Token时延)暴增,严重破坏用户体验。
对此,英特尔推出了KVShrink分层卸载与硬件压缩加速方案,核心思路是“以存代算、分层卸载、硬件压缩”。系统将KV Cache按访问热度分层流动:极热数据常驻L1层(GPU HBM显存),保障低延迟响应;热数据卸载至L2层(DDR内存),通过大容量缓存池扩容降本;温冷数据下沉至L3/L4层(本地SSD或远端分布式存储),实现持久化复用。CPU是驱动KVShrink机制运转的核心,承担着KV Cache压缩、调度、分层存储与生命周期管理的重要职责,其内置的英特尔QAT是KVShrink运转的重要基础。
针对不同服务器架构与GPU选型,英特尔提供了灵活的QAT加速方案:机头CPU为至强时,至强作为控制中枢,利用内置QAT引擎对卸载到Host DDR内存(L2)或本地SSD(L3)的KV Cache进行无损压缩与解压调度;在机头CPU并非至强或机头资源不足时,通过GDS/GPU Direct Storage和RDMA将KV Cache卸载到外部扩展节点或高性能存储形态的服务器,GPU通过GDS或GDR加GDS直接访问远端节点,该节点可采用JBOF等产品形态,并使用至强CPU执行KV Cache压缩及其他处理。
据介绍,通过QAT进行无损压缩,原本300GB的KV Cache可以在落盘之前压缩至200GB;通过DSA可实现数据搬运9.66倍的加速效果。客户验证数据显示,英特尔KV Cache智能加速套件能够将KV Cache传输速率最高提升达9.66倍,首字时延(TTFT)性能最高提升达15倍。
英特尔KV Cache智能加速套件已在GitHub上开源,涵盖KV Shrink、KV Infinity、KV Cascade、KV Fuse等方案,从扩展、压缩、聚焦到复用,形成KV Cache全生命周期优化,突破HBM容量边界并提升推理效率。
胡勇在受访中解释了一个看似矛盾的问题——为什么压缩和解压缩多了一道工作,速度反而提升?“我们做了一些设计,把任务的调度和编排,让每一层的KV Cache在处理这一层的时候就知道下一层要用,提前把它prefetch过来,把延迟隐藏在重叠的流水线当中。”他说道。
Sandbox:Agent时代的“必选项”
当AI Agent被纳入更多生产环境,作为Agent关键执行环境的沙箱(Sandbox)迅速从可选变成必选。据介绍,沙箱是一个轻量化的虚拟机(Micro-VM),无论是操作系统镜像还是文件系统都做了定制化裁剪,主要目的是在满足基本功能的情况下更快、更轻、占用更少内存、启动更快。沙箱存在的必要性在于两方面:保护自己——Agent处理敏感内容信息时不希望被系统中其他软件看到;保护他人——Agent执行的内容很多是大语言模型自己产生的,包括生成的代码、对文件系统的操作甚至访问外部系统,无法预料是否会出现问题。
业内衡量一套沙箱体系通常看三个指标:快(启动速度)、多(密度,一台服务器能同时承载多少沙箱直接决定成本)、独立(隔离到位,每个工作间互相独立)。英特尔的差异化优势在于IAA硬件加速与内存超卖。IAA(内存分析加速器)专门用于快照无损压缩数据的硬件级解压,其优势包括:CPU占用极低,解压过程几乎不占用CPU主频(CPU利用率接近0%);恢复速度相比不压缩方案,沙箱拉起/加载速度提升30%-50%;快照创建性能比未压缩方案提升接近2倍。
英特尔还强调了至强6+在沙箱场景中的系统级优势:至强6+在系统重载情况下不跳频,两百多个核心同时工作频率不下降,性能几乎线性交付;支持超配,一个CPU核心可同时部署4个甚至更高数量的Agent,分时复用系统资源;RAS特性和TDX加密隔离在Agent时代越来越重要,因为越来越多的任务执行时互相之间可能会有冲突,强隔离非常重要。
存储与网络:系统级协同
在存储层面,英特尔携手国内焱融科技,基于英特尔至强6处理器和MRDIMM内存打造了高性能全闪存储系统。焱融科技参与MLPerf Storage v3.0测试,在Llama3检查点读写和3D-Unet训练两项测试中取得全球第一的成绩。陈葆立表示:“我们打造这套高性能存储系统,最重要的是能够让存储跑得更快,避免数据访问成为瓶颈,让昂贵的CPU、GPU不必空等。”
在网络与GPU方面,英特尔发布了新一代GPU Crescent Island,基于全新Xe3P架构,面向AI推理和Agentic AI场景设计,通过LPDDR5x技术可配备128G、256G甚至480G大容量内存,帮助更好地进行AI推理和KV Cache存储。软件层面,英特尔在PyTorch、vLLM、SGLang等开源项目中持续投入,希望包括Agentic AI在内的新功能能够在社区项目中得到体现,更好地适配不同硬件。
据透露,英特尔正在与包括OEM和液冷厂商在内的国内众多硬件合作伙伴,共同制定面向AI智能体的CPU机架方案标准。根据目前可预见的AI智能体性能需求,综合考虑CPU性能、网络、存储、散热以及供电,打造一套平衡的、全新的面向AI智能体的CPU机架方案,核心数可达5万以上,支持多模式混合部署、CXL内存弹性扩展与池化,并优化供电与液冷部署。英特尔将很快与国内合作伙伴一起将其推向市场。
结语
在演讲结尾,陈葆立回归大会主题“开放、合作、创新”:“智能体时代才刚刚开始,未来肯定会有很多新的创新、新的挑战。有一句老话说得好——独行快、众行远。未来的AI发展道路上有很多机会、很多挑战,我们也希望继续与产业界伙伴携手创新,拥抱未来的新世界。”
从至强6+的288核高密度算力,到KVShrink的全生命周期KV Cache优化,再到Sandbox的IAA硬件加速与CPU Rack行业标准制定,英特尔正在以CPU为中枢,构建一套覆盖云、边、端的完整智算中心方案。
正如陈葆立所言:“在英特尔那么多年,我们一直在重复做一件事,就是解决客户的问题。客户的问题每年可能不一样,但在问题出现的时候,如果能够通过我们技术的积累和技术的手段,帮助他们更快地完成他们想要做的事情,我觉得这就是帮助到客户成功,帮助到我们自己成功。”
责任编辑:SemiInsights
相关文章
-
- 半导体行业观察
-
- 摩尔芯闻
最新新闻
热门文章 本日 七天 本月
热门评论
©2025 半导体行业观察
Copyright©2023 芯算智能科技(扬州)有限公司
苏ICP备2025200240号-2 皖公网安备 34019202000656号